ずんだもんと学ぶアナログ回路

余談 #2

AI半導体なのにメモリ会社が大儲け? メモリウォールとHBM

「マイクロンやサムスンが好業績!株を買って大儲けなのだ!」

でも、AIの計算が盛り上がると、どうしてメモリメーカーにも需要が来るのでしょうか。

ずんだもんと四国めたんが、データの供給待ちで演算器が止まるメモリウォールを解説します。

HBMの積層と広い接続、HBFによる容量拡張、セルを多層化する3D DRAM、モデルに特化するTaalasまでを扱います。

巨大なKVキャッシュにHBFを使う可能性と、読み書きの遅延・書き込み負荷も考えます。

YouTube で見る(10:18)
  • 四国めたん(解説)
  • ずんだもん(質問)

1AI半導体なのにメモリ会社が好業績?

ずんだもん

AI半導体がすごいのだ!マイクロンやサムスンも好業績らしいのだ!
動画の画面(「AI半導体がすごいのだ!マイクロンやサムスンも好業績らしいのだ!」の場面)
図 1

ずんだもん

これは株を買って大儲けなのだ!

動画の画面(「これは株を買って大儲けなのだ!」の場面)
図 2

四国めたん

気が早いわね。好業績だけで、これから株が上がるとは決まらないわ。

動画の画面(「気が早いわね。好業績だけで、これから株が上がるとは決まらないわ。」の場面)
図 3

ずんだもん質問

でも、AIは計算が得意なチップの話なのに、なんでメモリメーカーなのだ?

四国めたん

今日はそこが主役よ。計算する速さと、データを運ぶ速さを分けて見ましょう。

2Micron・Samsungの決算を読む

四国めたん

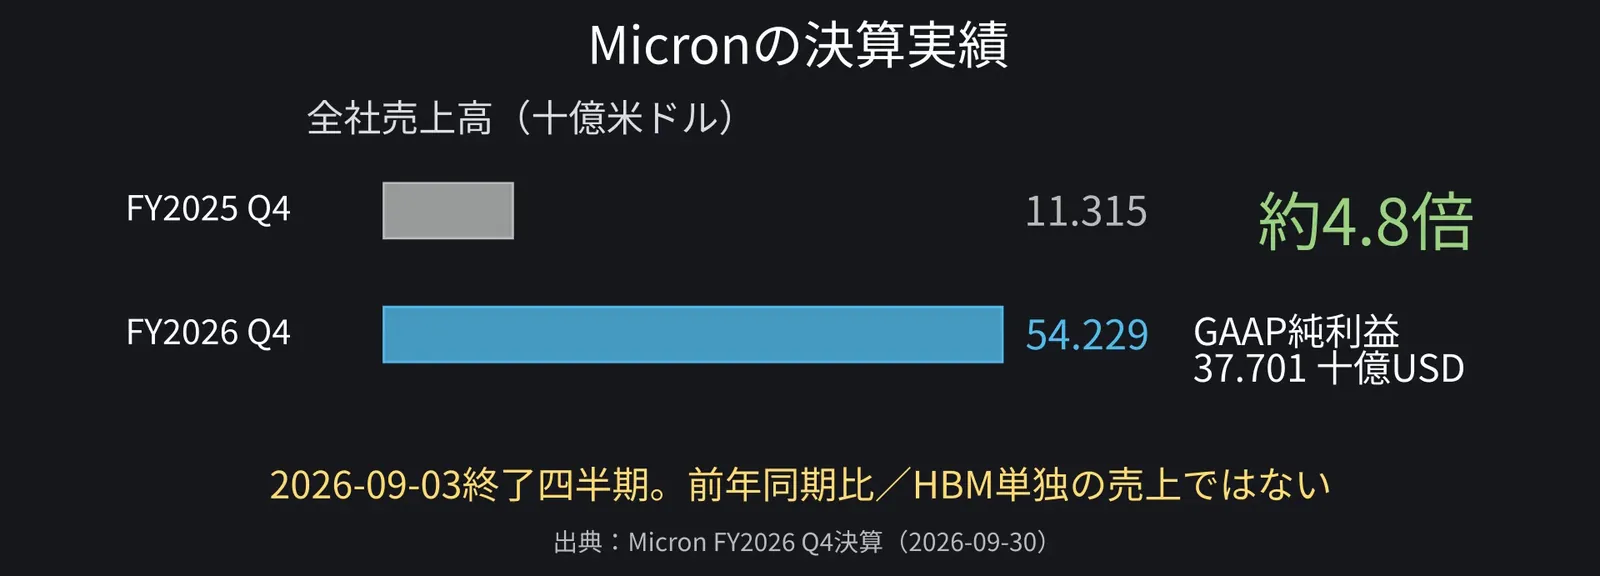
まず公表された実績ね。マイクロンの2026年度第4四半期、2026年6月から9月初めまでの3か月を見ましょう。

動画の画面(「まず公表された実績ね。マイクロンの2026年度第4四半期、2026年6月から9月初めまでの3か月を見ましょう。」の場面)
図 4

四国めたん

売上高は約542億ドル。前年同期の約113億ドルから大きく伸びたわ。

四国めたん:GAAP(米国会計基準)の純利益は約377億ドル。売上高と利益は別の数字だから、混ぜずに読んでね。

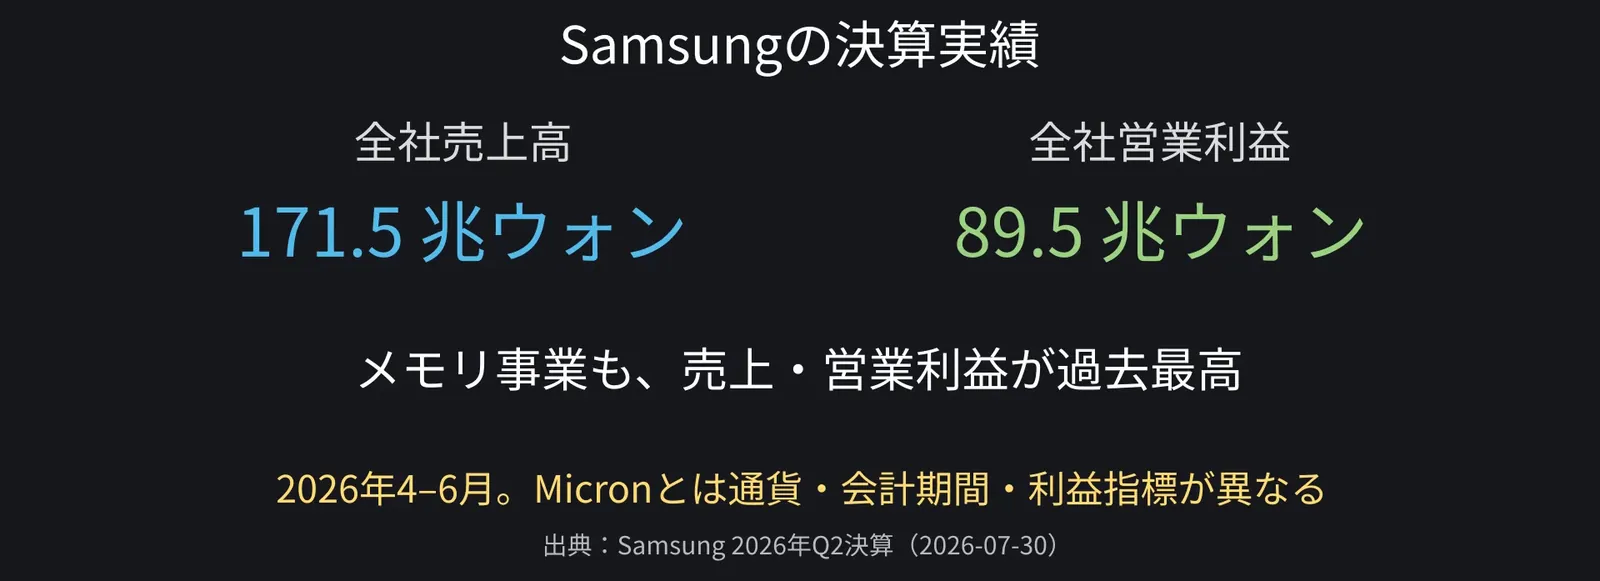
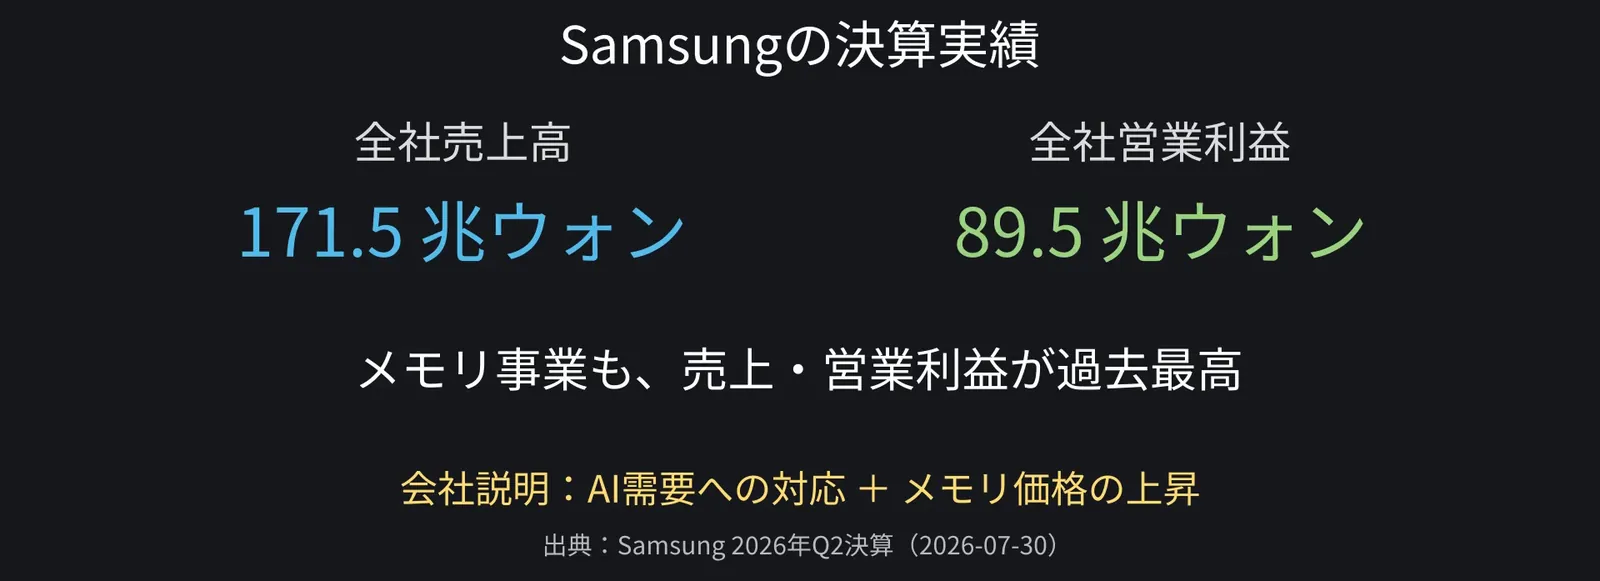
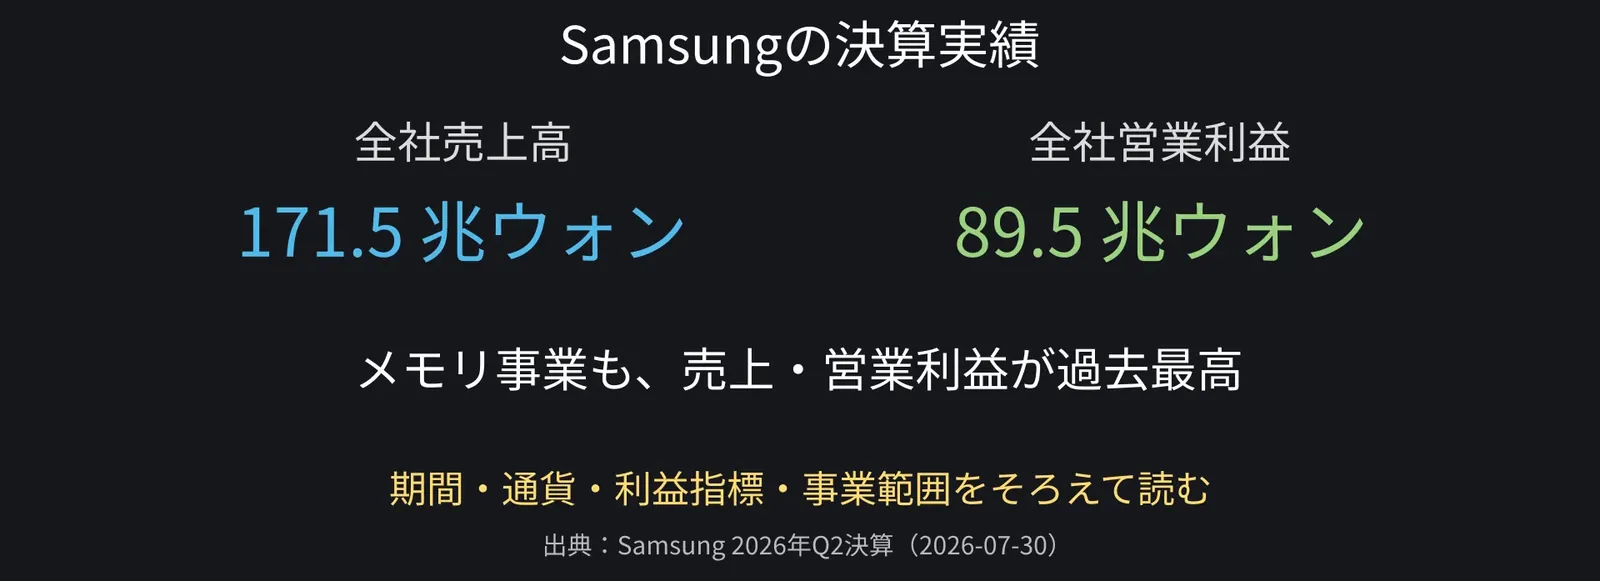
四国めたん:サムスンの2026年4月から6月は、全社売上高が171.5兆ウォンよ。

動画の画面(「サムスンの2026年4月から6月は、全社売上高が171.5兆ウォンよ。」の場面)
図 5

四国めたん

全社営業利益は89.5兆ウォン。メモリ事業も売上と営業利益が過去最高なの。

ずんだもん

会社全体とメモリ事業、営業利益と純利益も、混ぜないようにするのだ。
動画の画面(「会社全体とメモリ事業、営業利益と純利益も、混ぜないようにするのだ。」の場面)
図 6

四国めたん

サムスンはAI需要への対応に加え、メモリ価格の上昇も増益の理由に挙げているわ。

動画の画面(「サムスンはAI需要への対応に加え、メモリ価格の上昇も増益の理由に挙げているわ。」の場面)
図 7

四国めたん

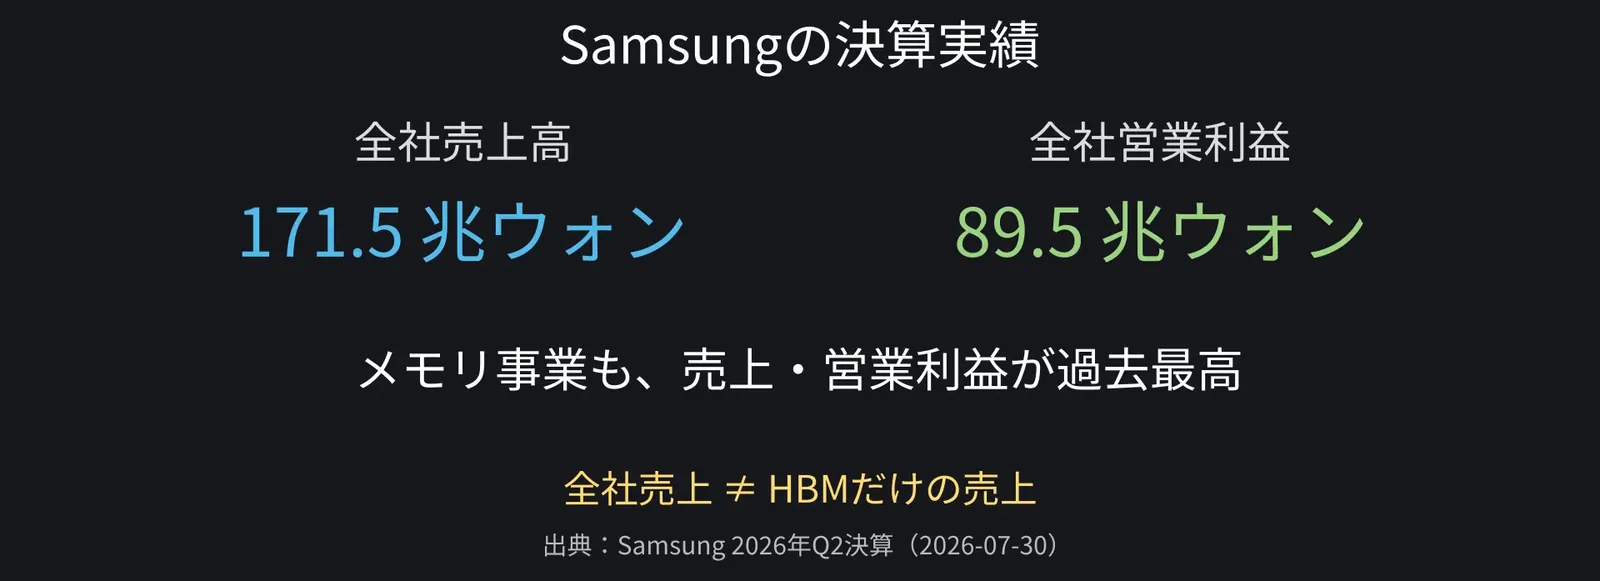
AI向けの高速メモリ、HBMだけの売上ではないわ。サーバ用DRAMやSSDも関わっているの。

動画の画面(「AI向けの高速メモリ、HBMだけの売上ではないわ。サーバ用DRAMやSSDも関わっているの。」の場面)
図 8

3メモリウォールとは何か

四国めたん

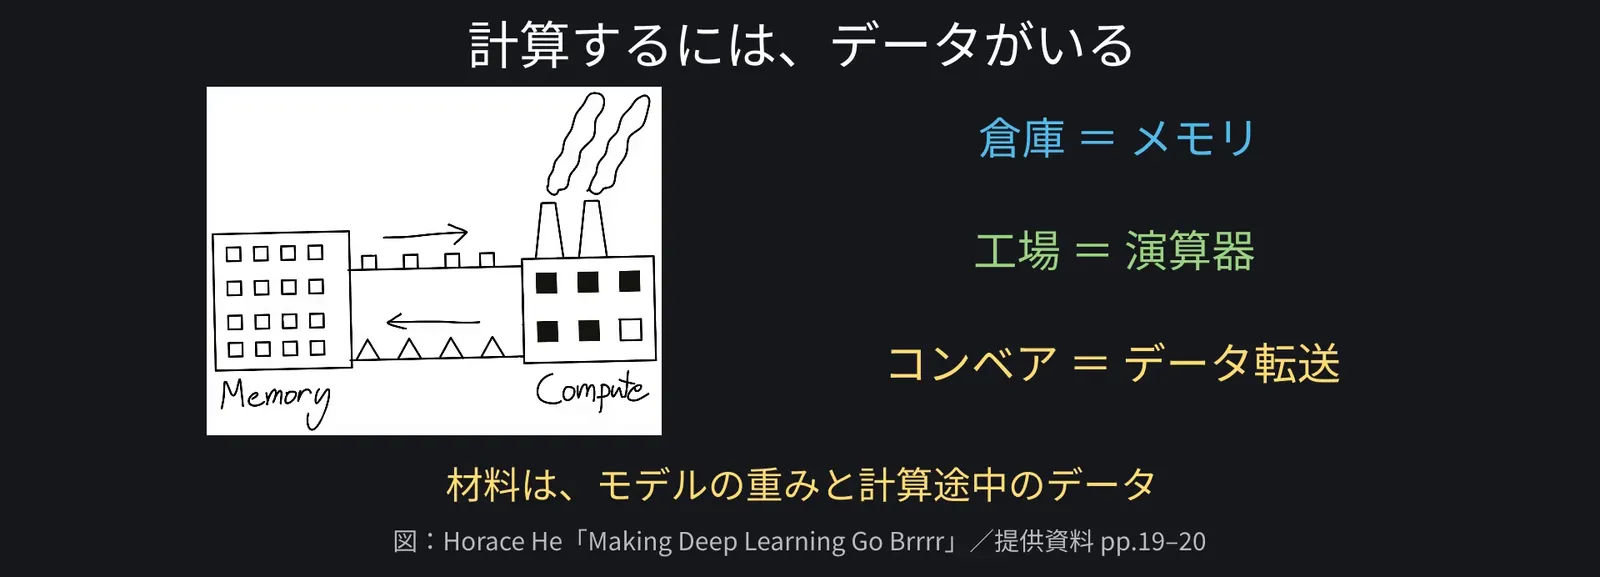
AIの計算を工場に例えるわ。演算器が工場の機械、メモリが材料の倉庫、その間のベルトコンベアがデータ転送よ。

四国めたん:倉庫には、モデルの重みや、計算途中のデータが入っているの。

動画の画面(「倉庫には、モデルの重みや、計算途中のデータが入っているの。」の場面)
図 9

ずんだもん質問

機械を増やせば、どんどん計算できるのだ?

四国めたん

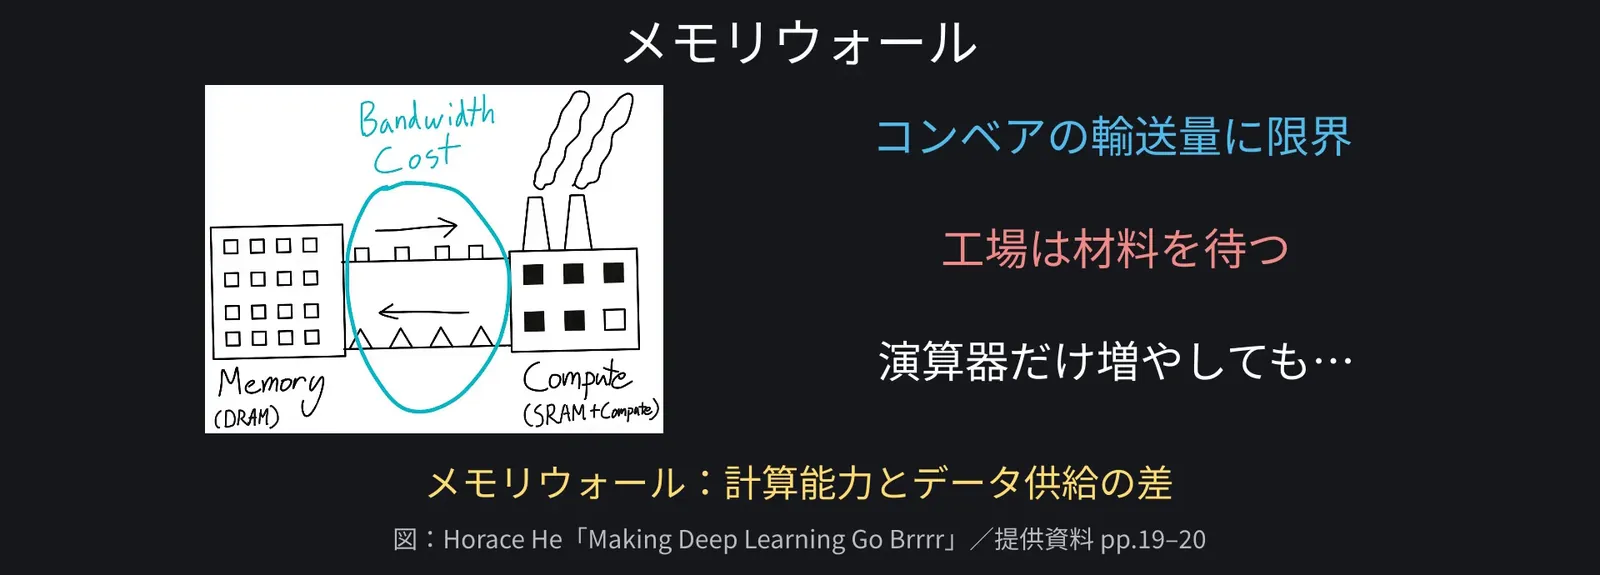
材料が届かなければ待ち時間になるわ。演算器だけ速くしても、仕事が進まないの。

四国めたん:この、演算器とメモリの性能差がメモリウォール。今日は特に、運べる量の限界を見るわ。

動画の画面(「この、演算器とメモリの性能差がメモリウォール。今日は特に、運べる量の限界を見るわ。」の場面)
図 10

四国めたん

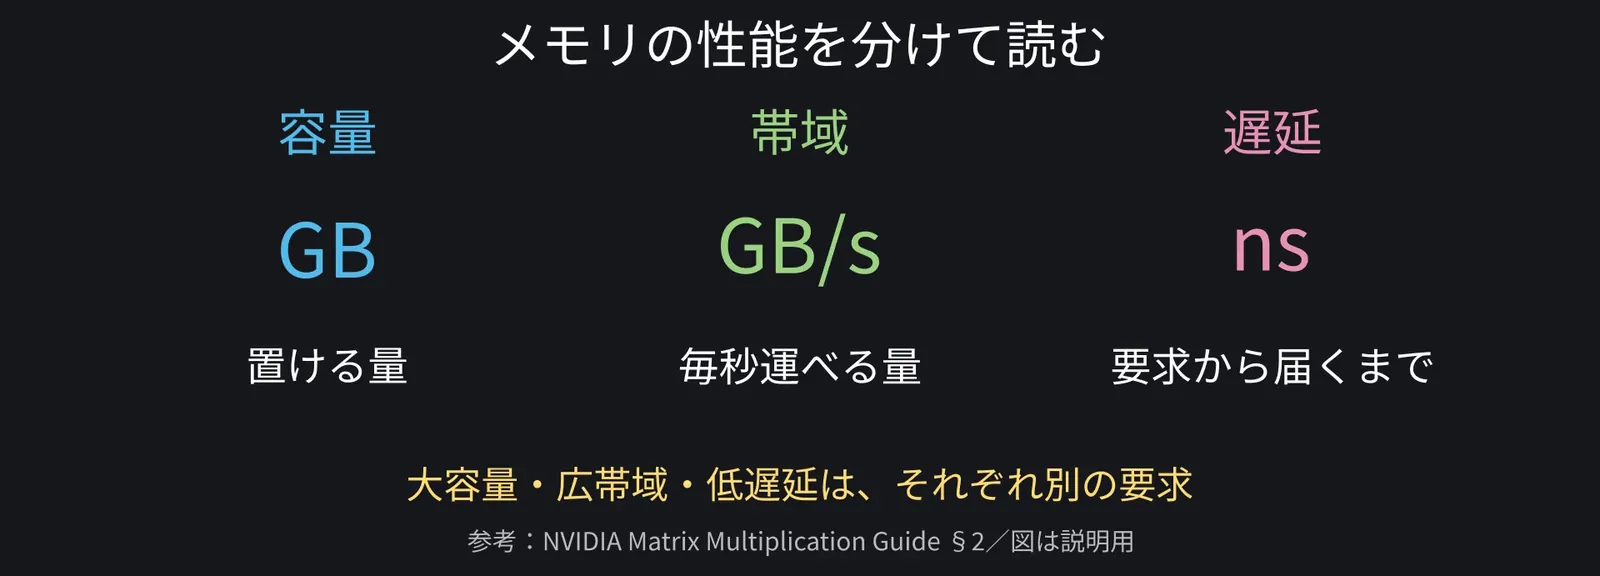
メモリの性能を三つに分けるわ。容量は何バイト置けるか。帯域は、1秒に何バイト運べるかよ。

動画の画面(「メモリの性能を三つに分けるわ。容量は何バイト置けるか。帯域は、1秒に何バイト運べるかよ。」の場面)
図 11

四国めたん

もう一つ、要求してから届くまでの遅延もあるわ。この三つは別の性能なの。

ずんだもん

倉庫の広さ、道路の輸送量、最初の荷物の到着時間、なのだ!

4メモリが遅いと何が起こる?
四国めたん

ここからは実製品ではなく、仕組みを理解するための計算例よ。

動画の画面(「ここからは実製品ではなく、仕組みを理解するための計算例よ。」の場面)
図 12

四国めたん

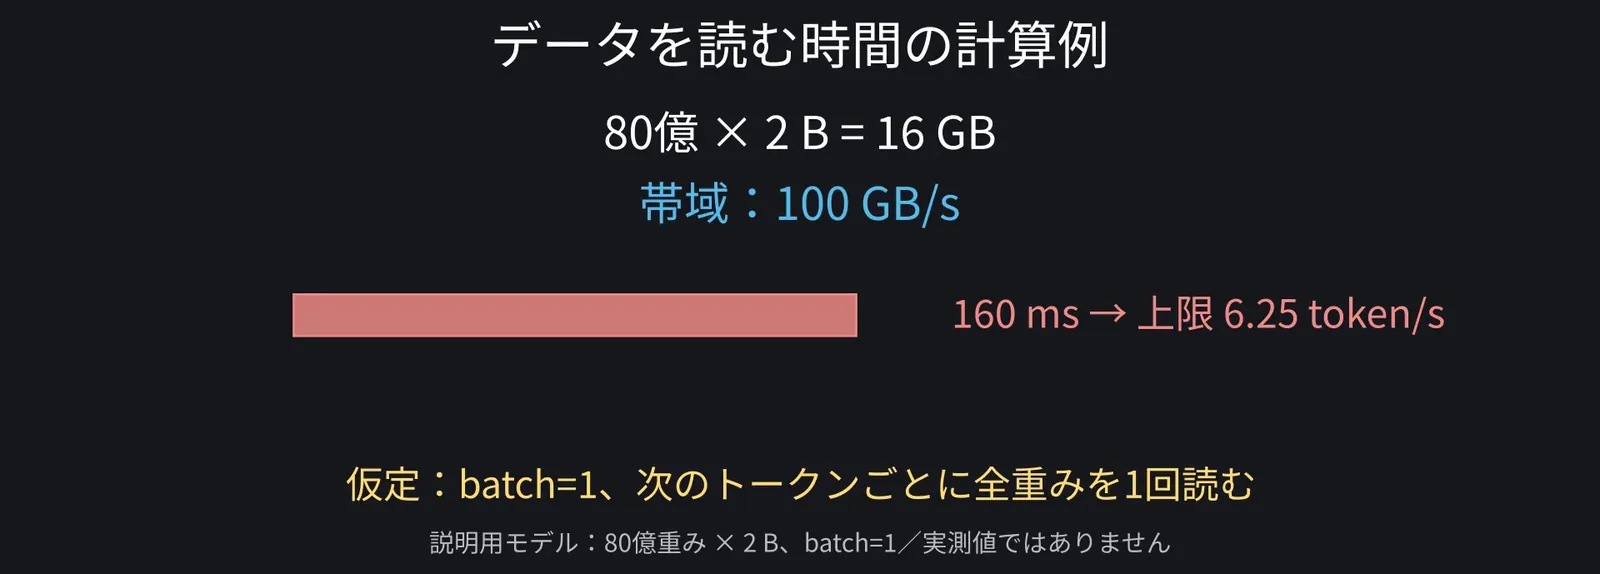
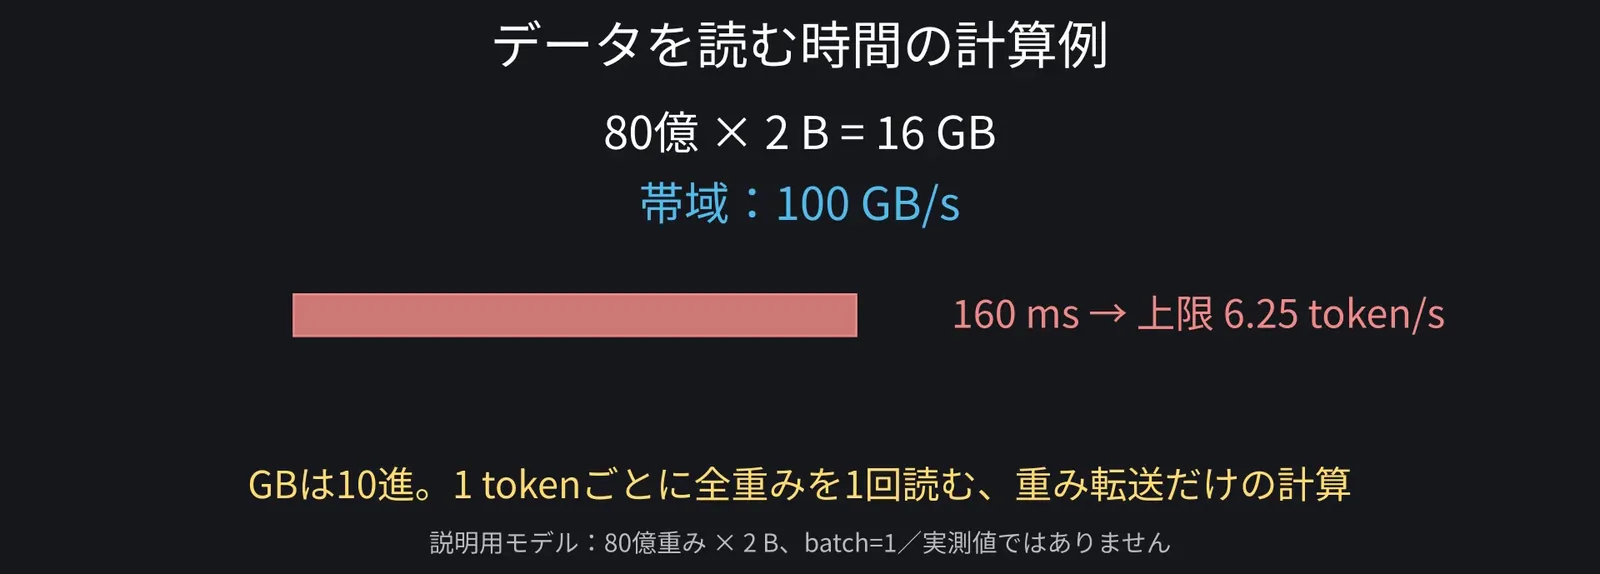
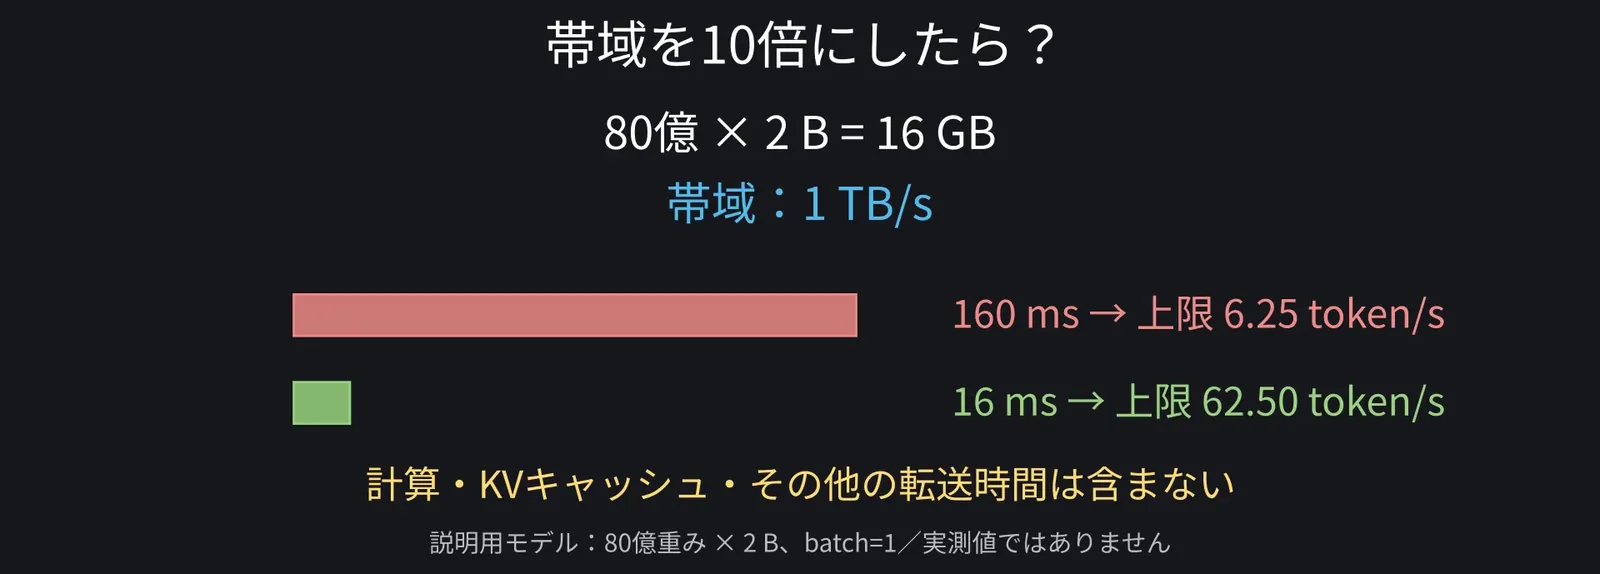
80億個の重みを、1個2バイトで保存すると、重みだけで16GBになるわ。

四国めたん:利用者1人に対して次の1トークン、つまり文章の次のひとかけらを作るたび、その重みを全部1回読み出すと仮定するの。

動画の画面(「利用者1人に対して次の1トークン、つまり文章の次のひとかけらを作るたび、その重みを全部1回読み出すと仮定するの。」の場面)
図 13

四国めたん

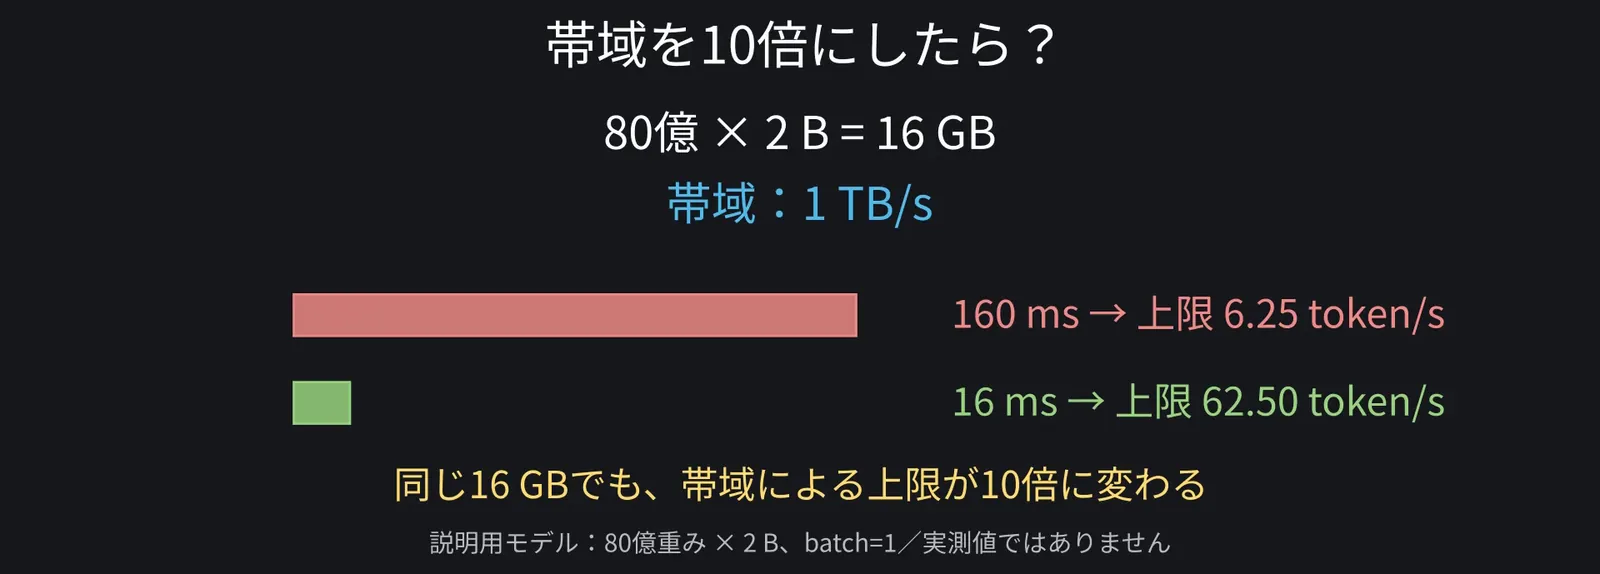
帯域が毎秒100GBなら、読み出すだけで160ミリ秒。毎秒約6トークンね。

四国めたん:毎秒1TBなら16ミリ秒。帯域だけから求めた上限は、毎秒62.5トークンよ。

動画の画面(「毎秒1TBなら16ミリ秒。帯域だけから求めた上限は、毎秒62.5トークンよ。」の場面)
図 14

ずんだもん

同じ計算機でも、データを運ぶ速さだけで、そんなに違うのだ!
四国めたん

実際は計算や他の読み書きも必要よ。この上限どおりの速さを保証するものではないわ。

動画の画面(「実際は計算や他の読み書きも必要よ。この上限どおりの速さを保証するものではないわ。」の場面)
図 15

四国めたん

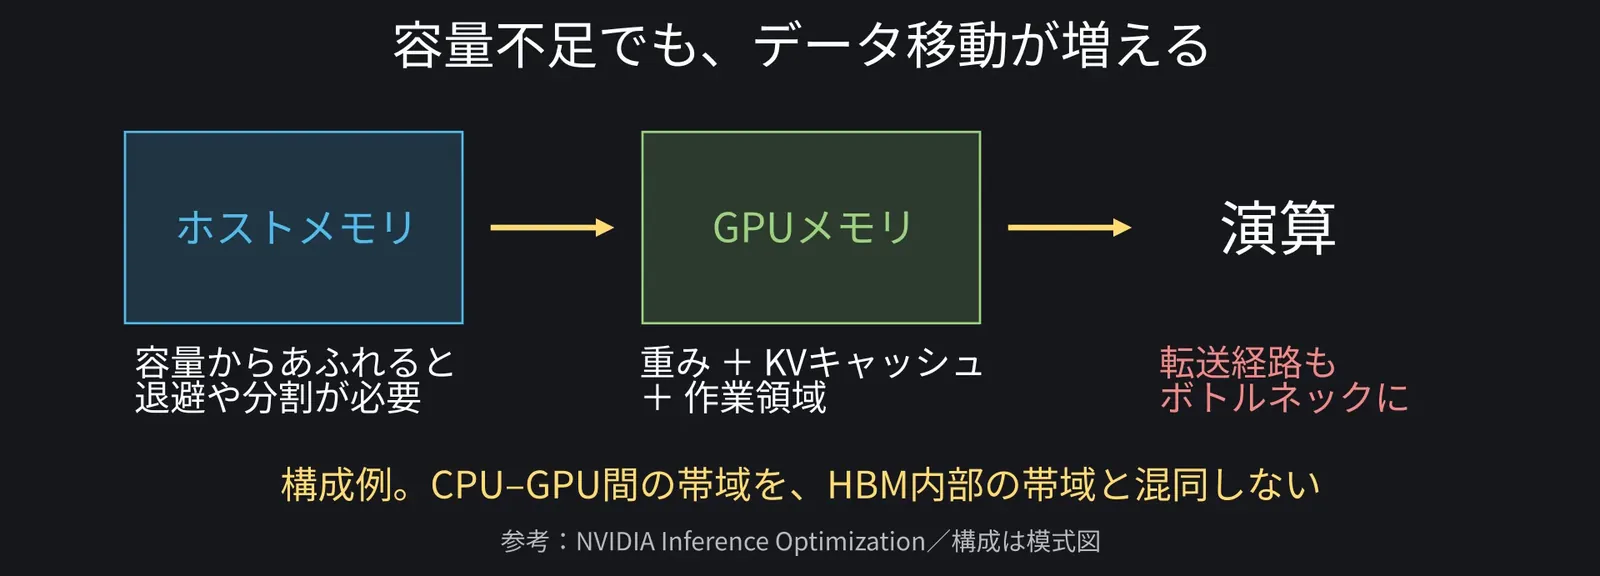
そもそも容量が足りなければ、モデルを載せられないこともあるわ。

動画の画面(「そもそも容量が足りなければ、モデルを載せられないこともあるわ。」の場面)
図 16

四国めたん

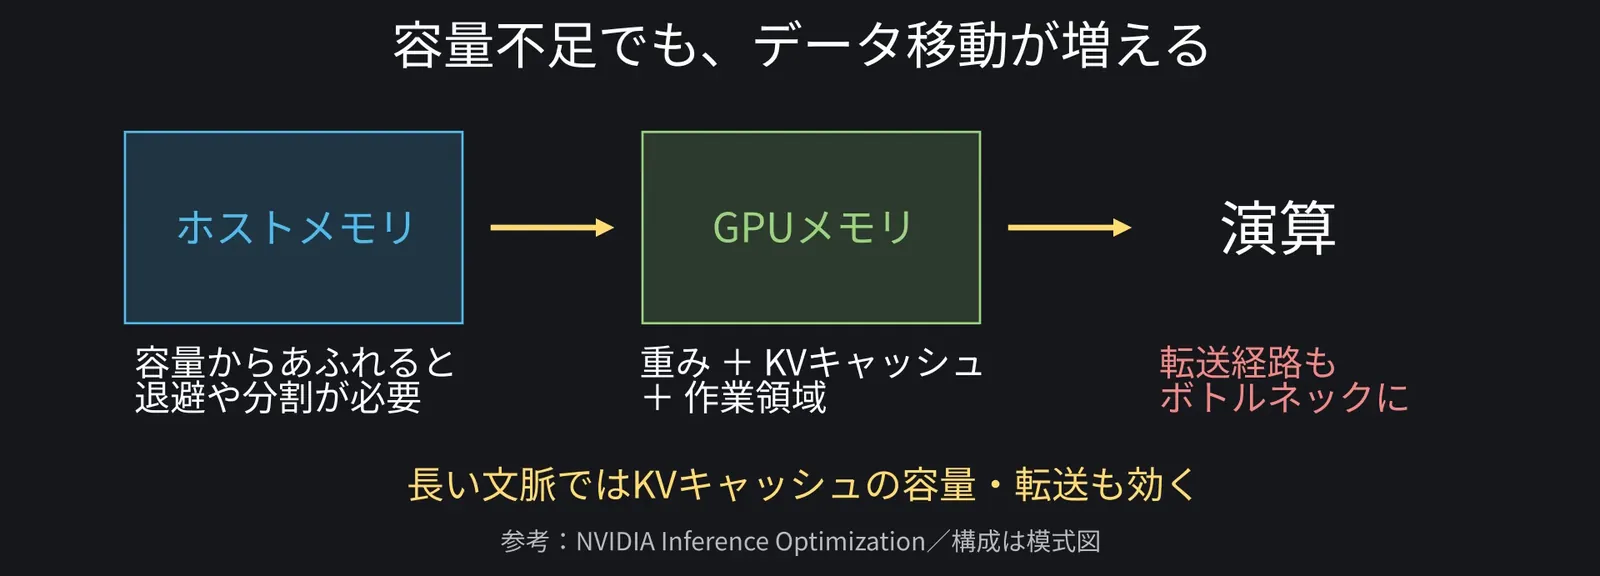
GPUのメモリに収まらない分をホスト側のメモリへ退避すると、その間の転送が追加される。その通り道の帯域が効いてくるの。

四国めたん:長い会話では、過去のトークンの情報を残すKVキャッシュの容量も必要になるわ。

動画の画面(「長い会話では、過去のトークンの情報を残すKVキャッシュの容量も必要になるわ。」の場面)
図 17

5Rooflineモデルと計算律速

四国めたん

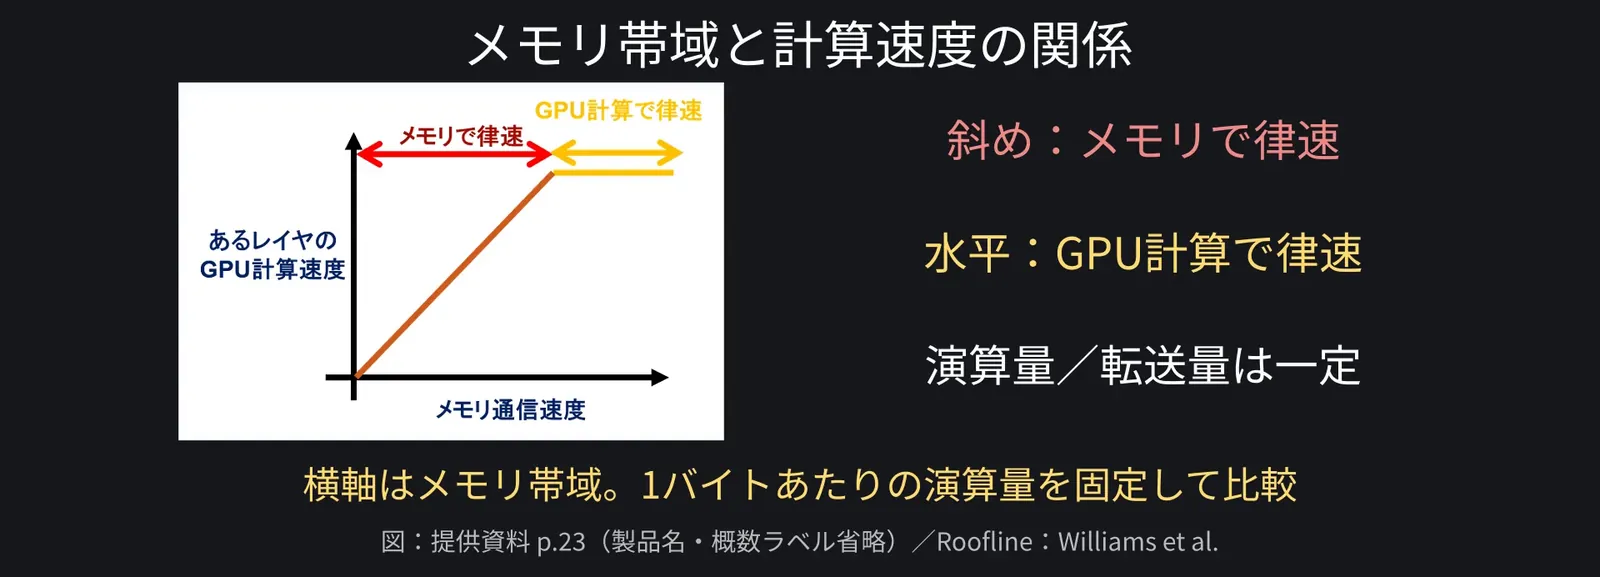
この制約はルーフラインモデルで整理できるわ。講義資料の図を見てみましょう。

四国めたん:横軸はメモリ通信の速さ、縦軸は計算速度よ。処理の中身は変えず、1バイトあたりの演算量を同じにしたまま、帯域だけを変えたらどうなるかを見るの。

動画の画面(「横軸はメモリ通信の速さ、縦軸は計算速度よ。処理の中身は変えず、1バイトあたりの演算量を同じにしたまま、帯域だけを変えたらどうなるかを見るの。」の場面)
図 18

四国めたん

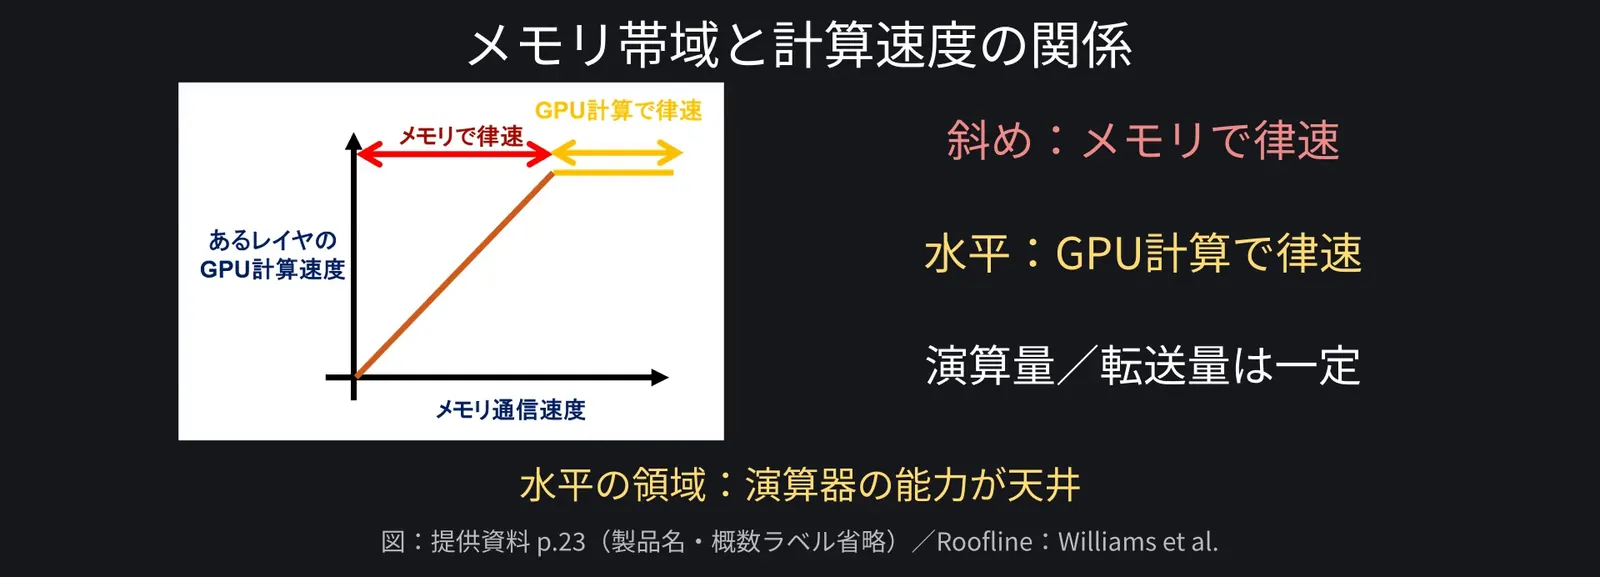
左の斜めの線では、帯域が性能を制限する。これがメモリ律速よ。

四国めたん:右の水平な天井では、演算器の能力が限界。こちらは計算律速ね。

動画の画面(「右の水平な天井では、演算器の能力が限界。こちらは計算律速ね。」の場面)
図 19

ずんだもん

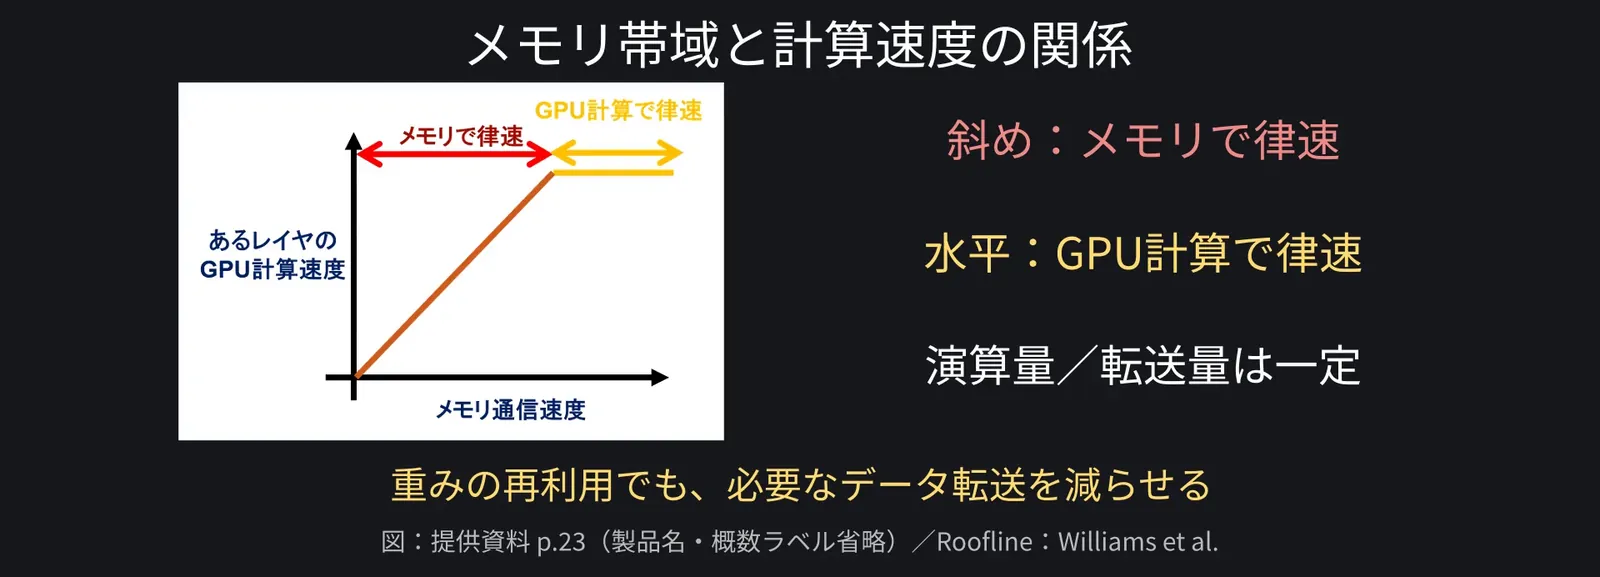
メモリを速くしても、天井より上には行けないのだ。

四国めたん

複数人の処理をまとめて同じ重みを再利用すると、運ぶ量あたりの演算を増やせるわ。

動画の画面(「複数人の処理をまとめて同じ重みを再利用すると、運ぶ量あたりの演算を増やせるわ。」の場面)
図 20

四国めたん

少人数の逐次生成と、入力をまとめて読む処理(プリフィル)や学習では、ボトルネックも変わるの。

四国めたん:AIの処理が全部メモリ律速、とは言い切れないのよ。

6HBMのしくみと広い帯域

ずんだもん質問

そこでHBMなのだ!でも、そもそも何者なのだ?
四国めたん

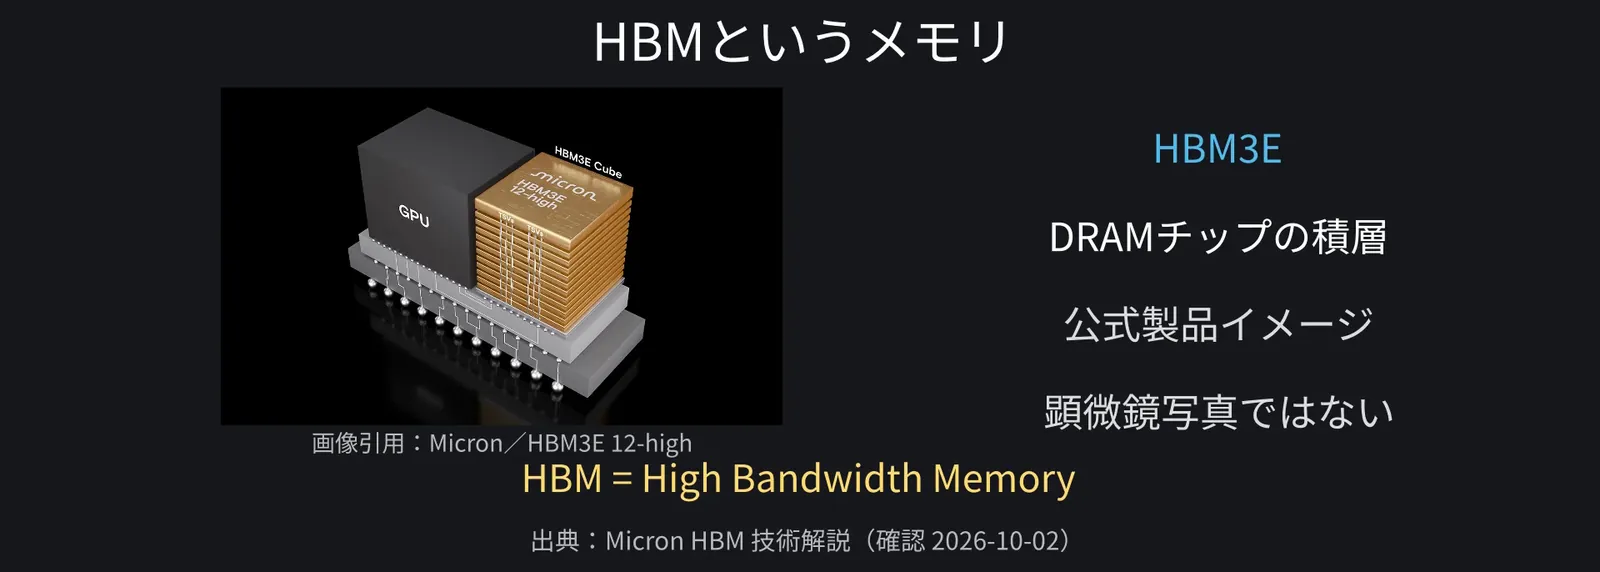
ハイ・バンドウィズ・メモリ。広い帯域を持つ、DRAMの仲間よ。

動画の画面(「ハイ・バンドウィズ・メモリ。広い帯域を持つ、DRAMの仲間よ。」の場面)
図 21

四国めたん

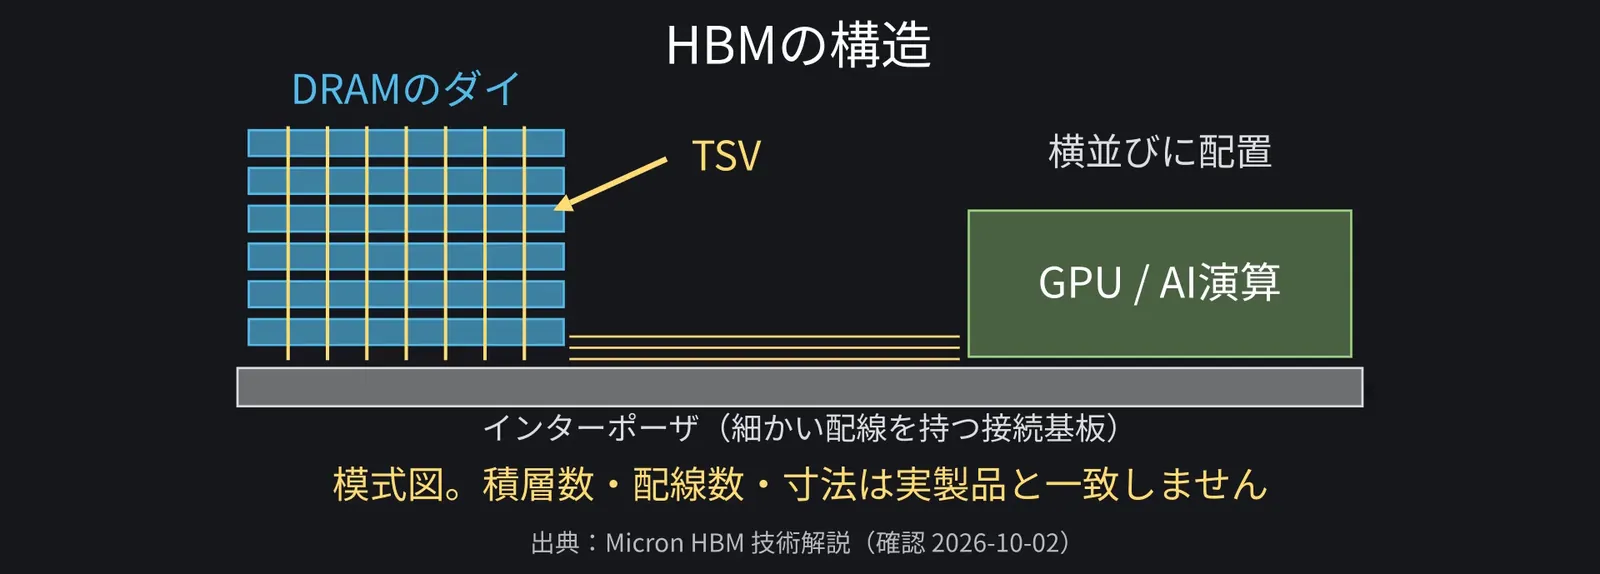
これはマイクロンが公開しているHBM3Eの製品画像よ。小さな積層体なの。

四国めたん:DRAMのチップを何枚も積み、TSVというシリコンを貫く配線でつなぐわ。

動画の画面(「DRAMのチップを何枚も積み、TSVというシリコンを貫く配線でつなぐわ。」の場面)
図 22

四国めたん

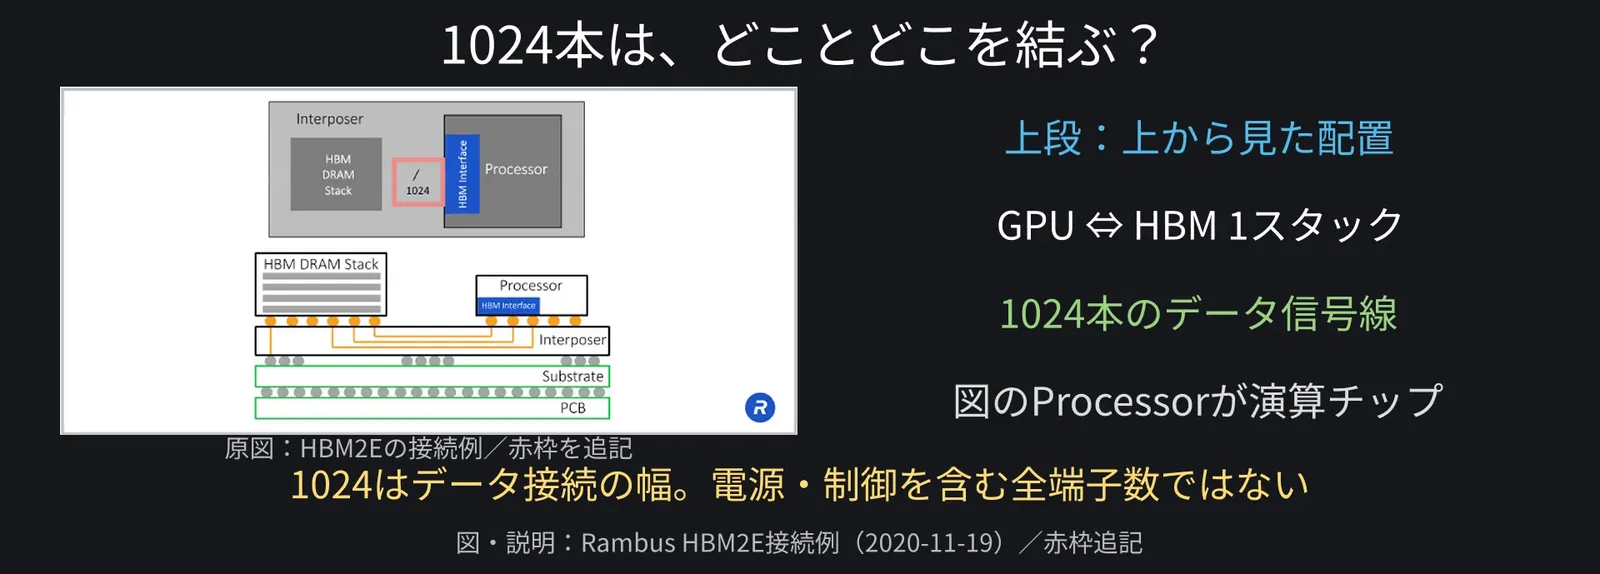
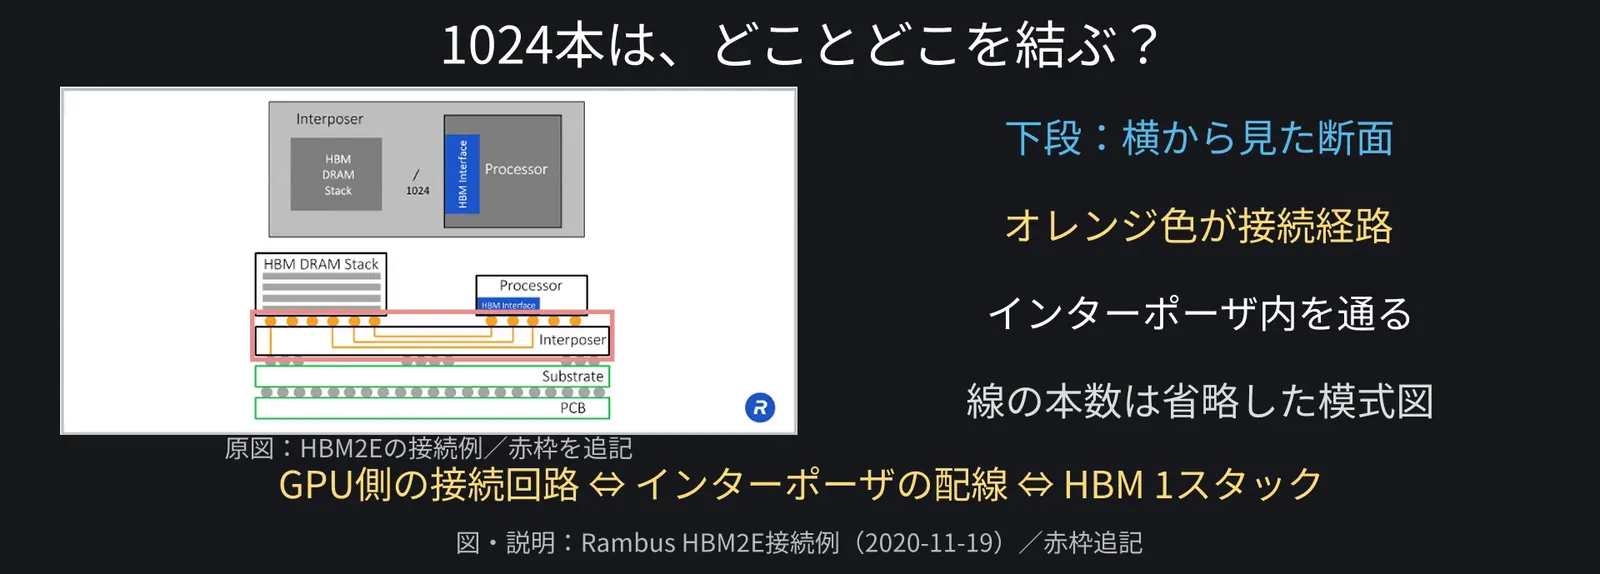
図の上段、上から見た配置にある「1024」は、GPUとHBMの積層体を結ぶデータ信号線の数よ。

動画の画面(「図の上段、上から見た配置にある「1024」は、GPUとHBMの積層体を結ぶデータ信号線の数よ。」の場面)
図 23

ずんだもん

図の下段、横から見た断面のオレンジ色の線が、その通り道なのだ!
動画の画面(「図の下段、横から見た断面のオレンジ色の線が、その通り道なのだ!」の場面)
図 24

四国めたん

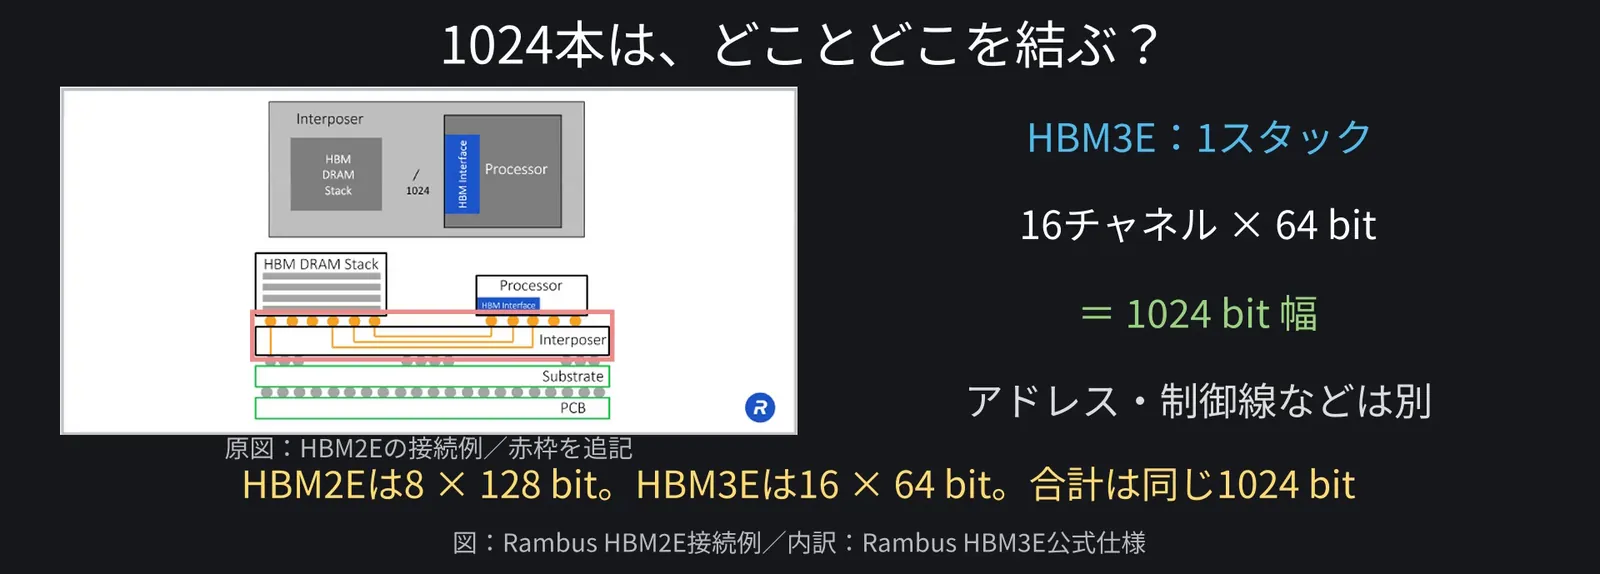
HBM3Eでは、64ビットのチャネルが16個で、合計1024ビット幅になるわ。

動画の画面(「HBM3Eでは、64ビットのチャネルが16個で、合計1024ビット幅になるわ。」の場面)
図 25

四国めたん

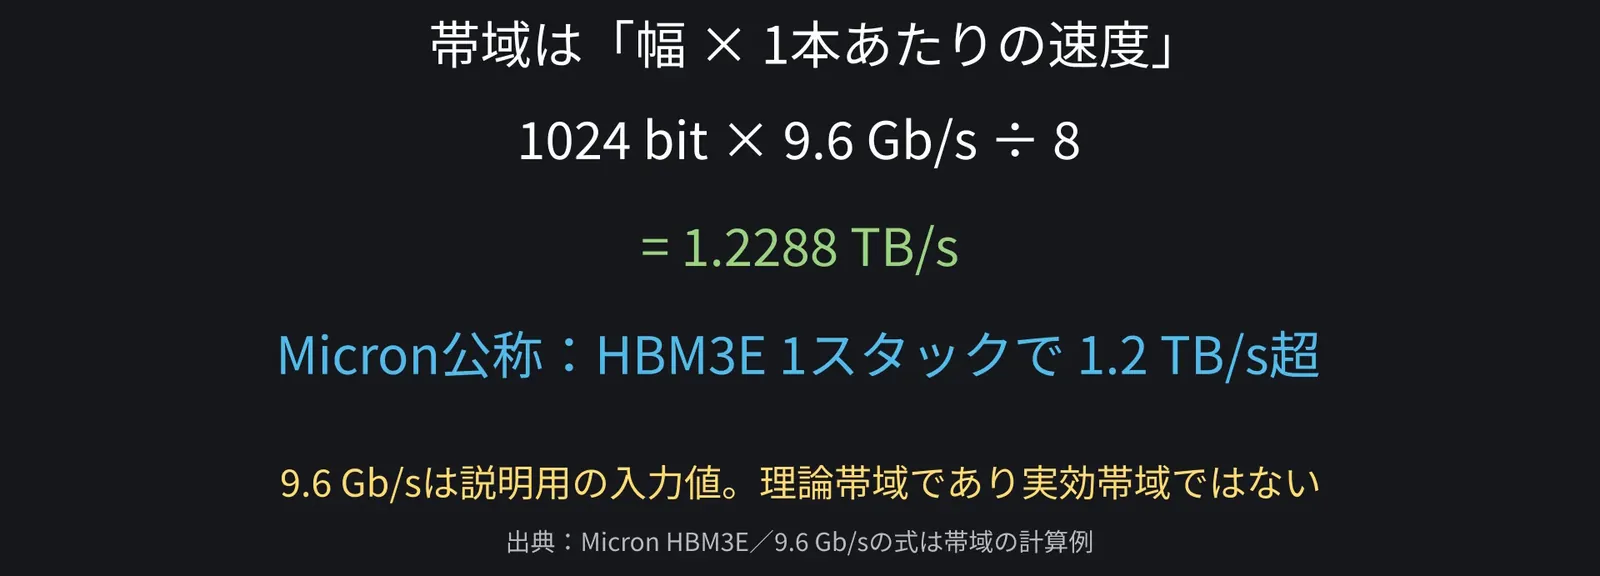
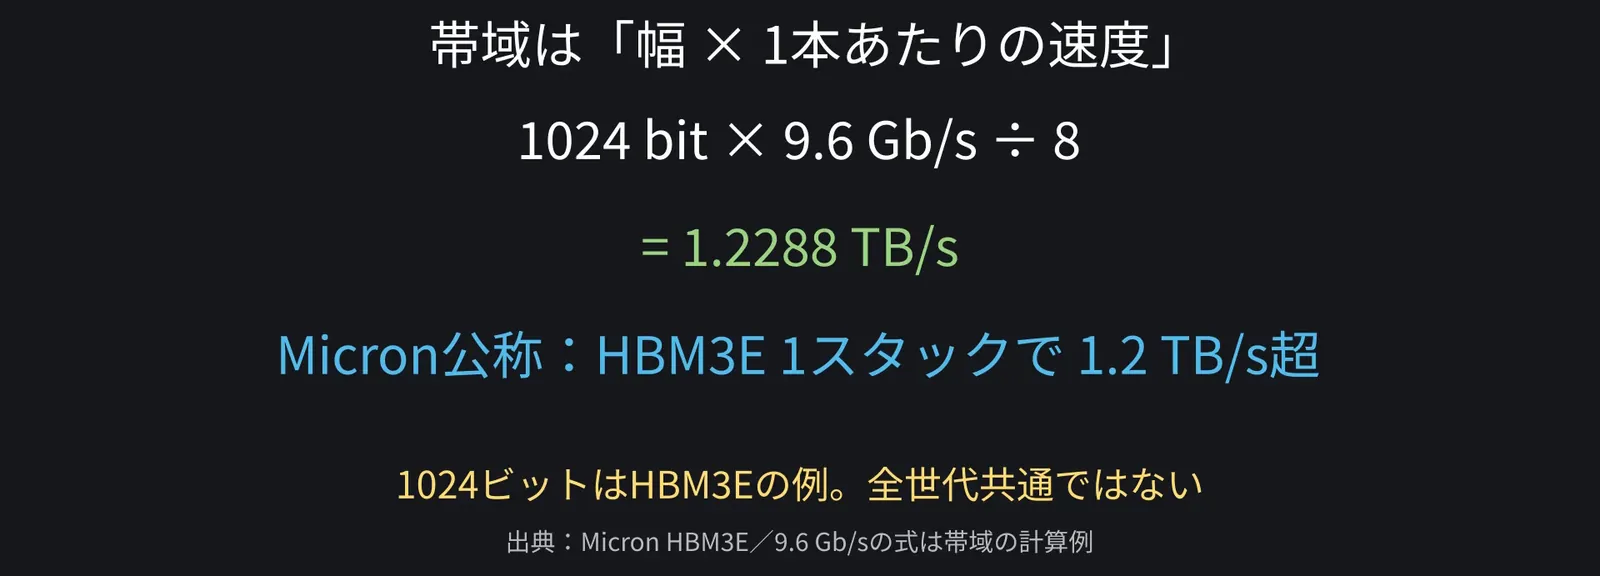
1本あたり毎秒9.6ギガビットなら、1024本×9.6ギガビット÷8で、計算上は合計毎秒1.2288テラバイトね。

動画の画面(「1本あたり毎秒9.6ギガビットなら、1024本×9.6ギガビット÷8で、計算上は合計毎秒1.2288テラバイトね。」の場面)
図 26

四国めたん

マイクロンのHBM3Eは、1スタックで毎秒1.2TB超と公表されているわ。

四国めたん:これはHBM3Eの例よ。世代が変われば、幅や速度、容量も変わるの。

動画の画面(「これはHBM3Eの例よ。世代が変われば、幅や速度、容量も変わるの。」の場面)
図 27

72.5Dと3D、放熱とコスト

四国めたん

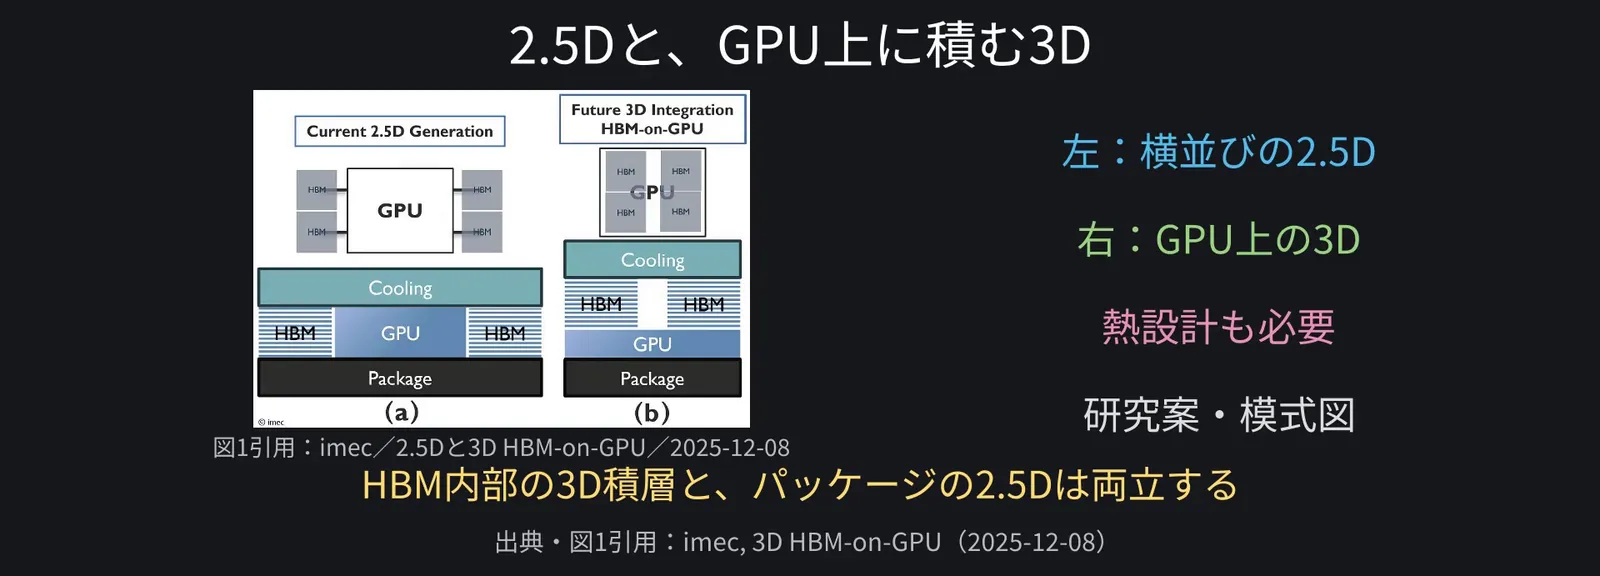
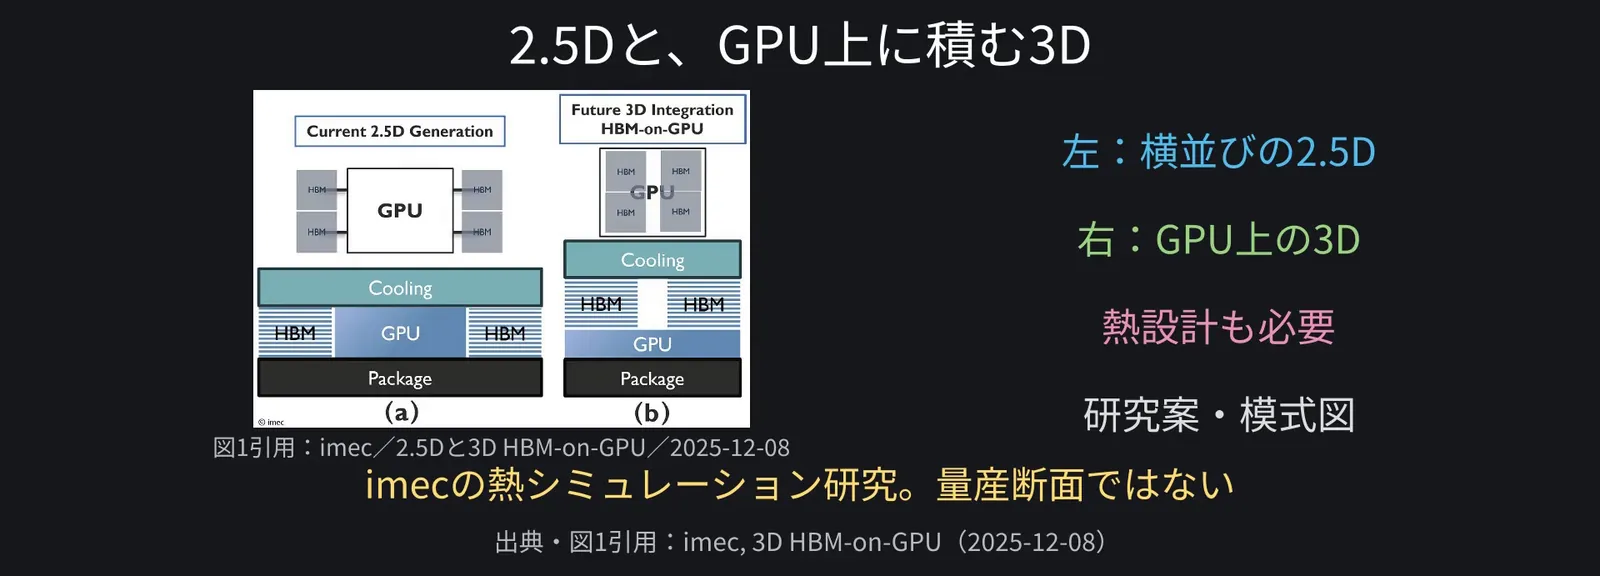
図の左では、GPUの周りにHBMを並べているわ。横並びの構成ね。

四国めたん:HBMの中は3D積層。GPUと横並びに載せるパッケージは、2.5Dと呼ぶの。

動画の画面(「HBMの中は3D積層。GPUと横並びに載せるパッケージは、2.5Dと呼ぶの。」の場面)
図 28

四国めたん

右はGPUの上にHBMを載せる研究案よ。上下に近づけると、熱の逃げ道も課題になるわ。

四国めたん:imecの熱シミュレーション研究で、量産製品の断面写真ではないわ。

動画の画面(「imecの熱シミュレーション研究で、量産製品の断面写真ではないわ。」の場面)
図 29

四国めたん

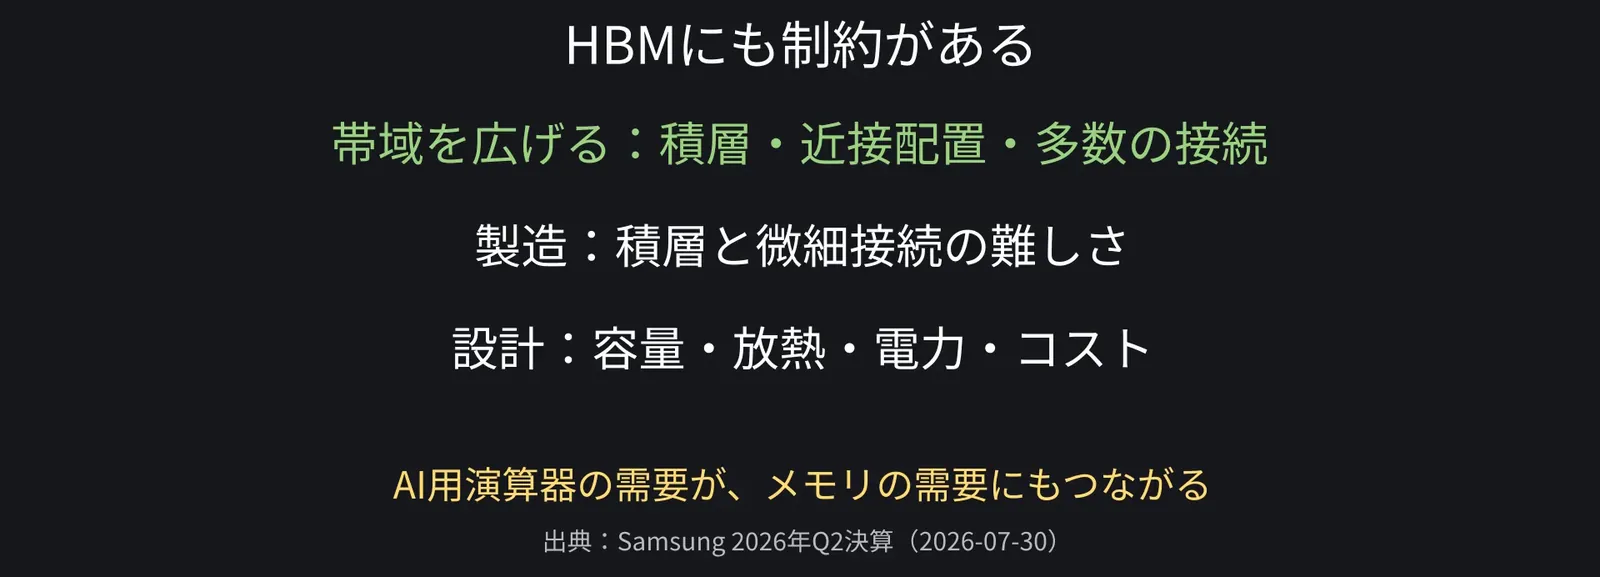
HBMにも、積層や接続の製造、放熱、コスト、容量の制約があるわ。

動画の画面(「HBMにも、積層や接続の製造、放熱、コスト、容量の制約があるわ。」の場面)
図 30

四国めたん

帯域が増えても、DRAMの読み出し遅延が同じ倍率で短くなるわけではないの。

動画の画面(「帯域が増えても、DRAMの読み出し遅延が同じ倍率で短くなるわけではないの。」の場面)
図 31

四国めたん

必要な帯域と容量、電力、価格しだいで、グラフィックス向けのGDDRや低消費電力のLPDDRなども使い分けるわ。

動画の画面(「必要な帯域と容量、電力、価格しだいで、グラフィックス向けのGDDRや低消費電力のLPDDRなども使い分けるわ。」の場面)
図 32

ずんだもん

計算チップを活かすにはメモリも要る。だからメモリメーカーにも需要が来るのだ!
動画の画面(「計算チップを活かすにはメモリも要る。だからメモリメーカーにも需要が来るのだ!」の場面)
図 33

8HBFはHBMと何が違う?

ずんだもん質問

HBFというのも出てきたのだ。HBMの新しい世代なのだ?
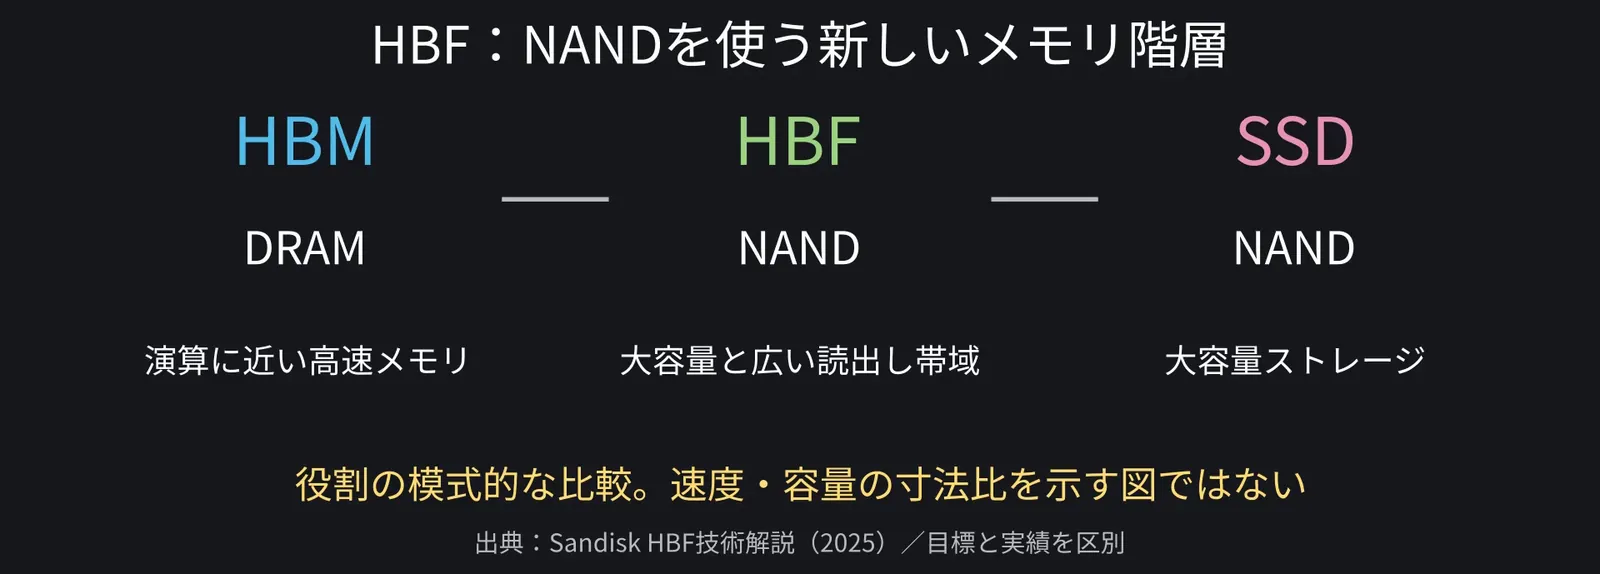
動画の画面(「HBFというのも出てきたのだ。HBMの新しい世代なのだ?」の場面)
図 34

四国めたん

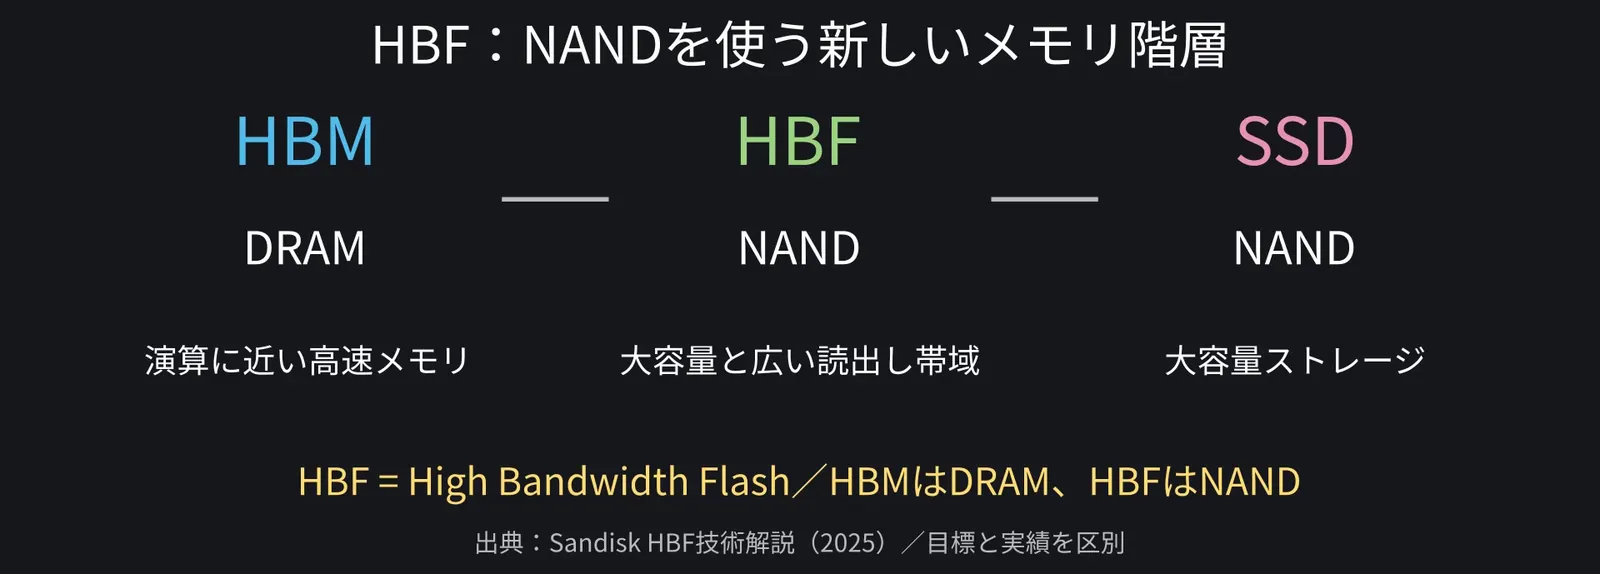
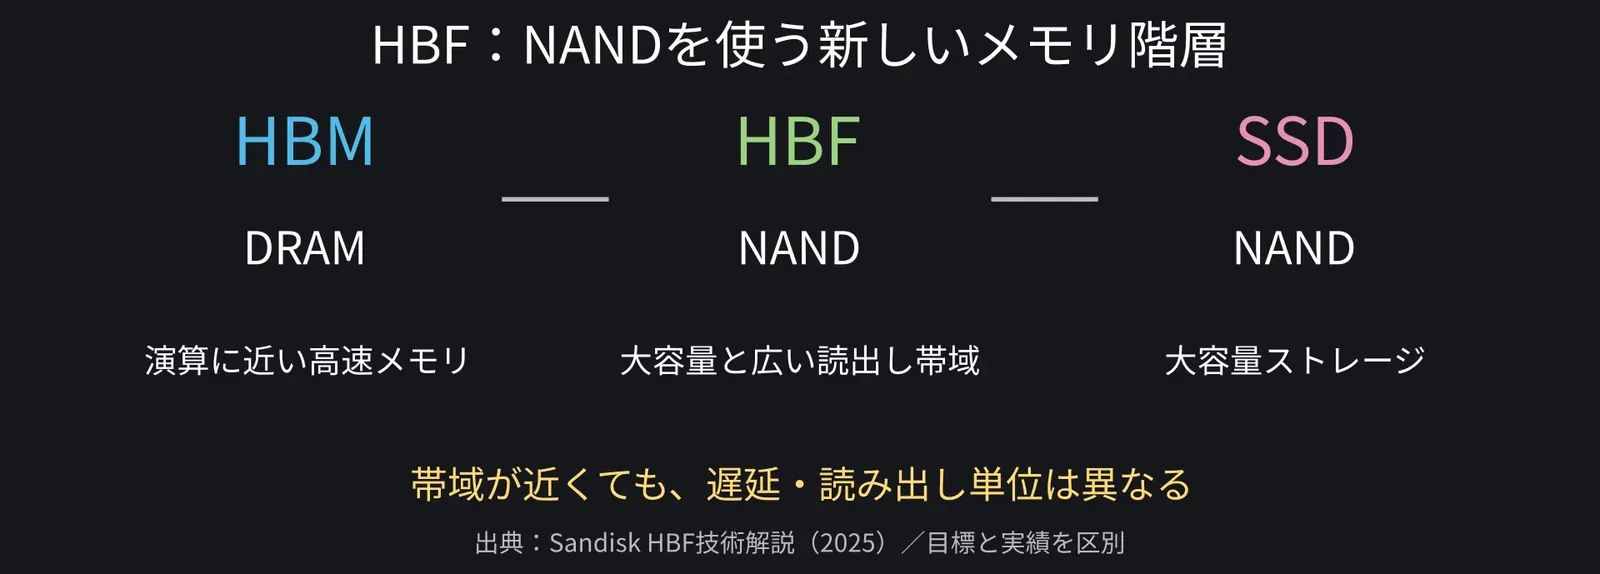
ハイ・バンドウィズ・フラッシュよ。こちらはNANDフラッシュを使うの。

動画の画面(「ハイ・バンドウィズ・フラッシュよ。こちらはNANDフラッシュを使うの。」の場面)
図 35

四国めたん

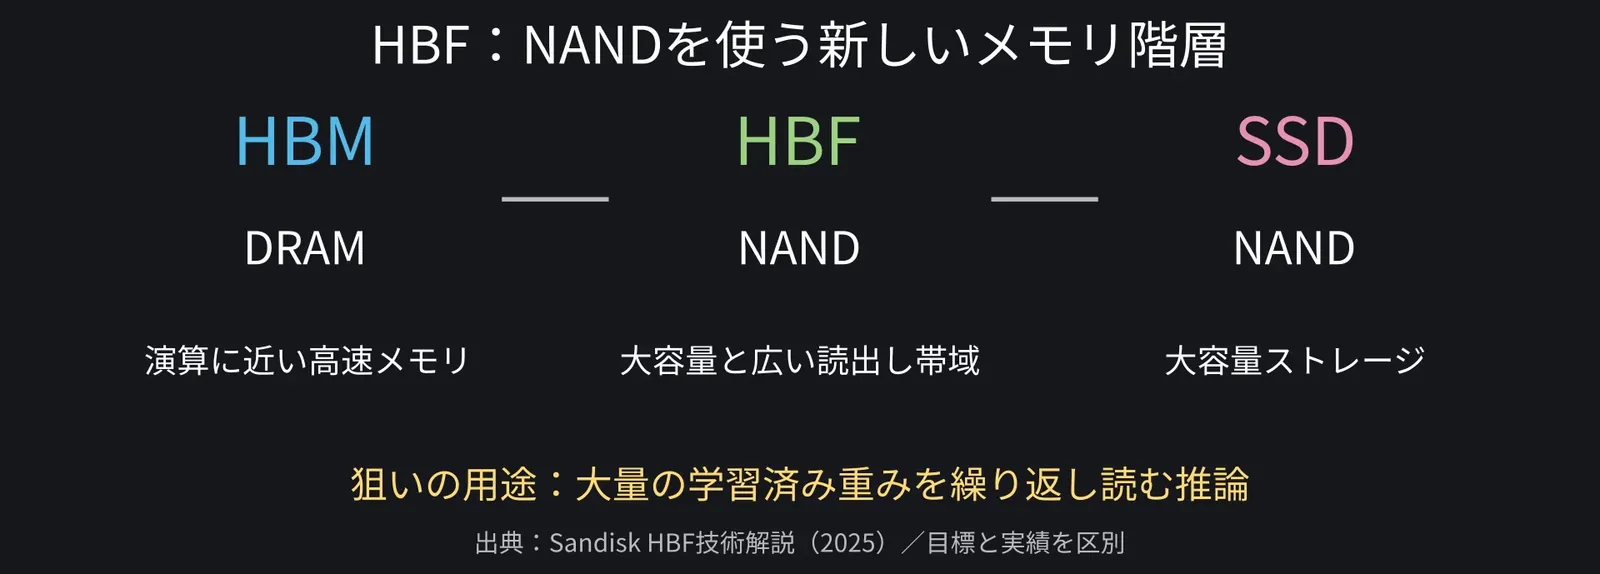
大容量が得意なNANDに、並列なデータ経路を作り、広い読み出し帯域も狙うわ。

四国めたん:HBMとSSDの間を埋める、新しい階層という位置づけね。

四国めたん:例えば、大量に保存した学習済みの重みを繰り返し読む推論が、狙いの用途なの。

動画の画面(「例えば、大量に保存した学習済みの重みを繰り返し読む推論が、狙いの用途なの。」の場面)
図 36

四国めたん

HBMより遅延や読み出し単位が大きい点に注意ね。同じ帯域でも、使い勝手は違うわ。

動画の画面(「HBMより遅延や読み出し単位が大きい点に注意ね。同じ帯域でも、使い勝手は違うわ。」の場面)
図 37

ずんだもん

容量が大きいからといって、HBMを何でも置き換えられるわけではないのだ。
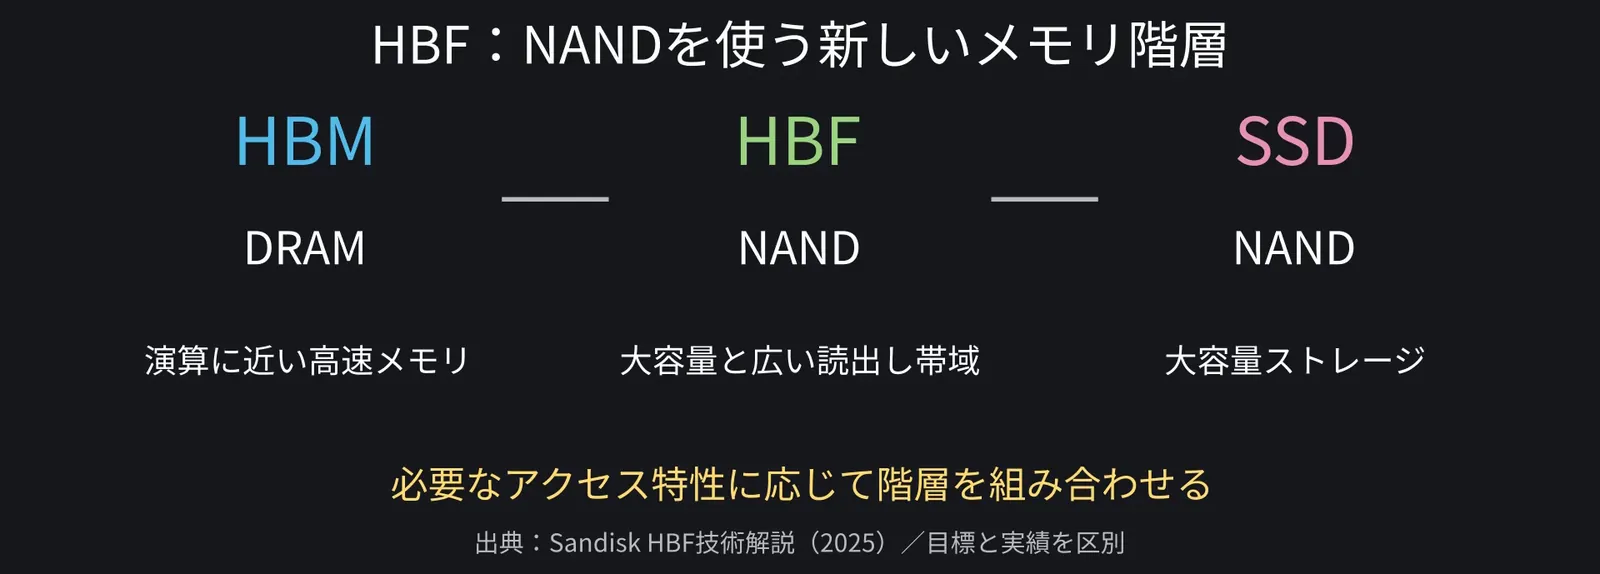
動画の画面(「容量が大きいからといって、HBMを何でも置き換えられるわけではないのだ。」の場面)
図 38

四国めたん

NANDの読み出しや書き込みには時間がかかる。並列化で帯域を稼いでも、遅延は残るの。

9巨大なKVキャッシュとHBFの遅延

ずんだもん

でも、KVキャッシュがものすごく大きいときには、有効かもしれないのだ!
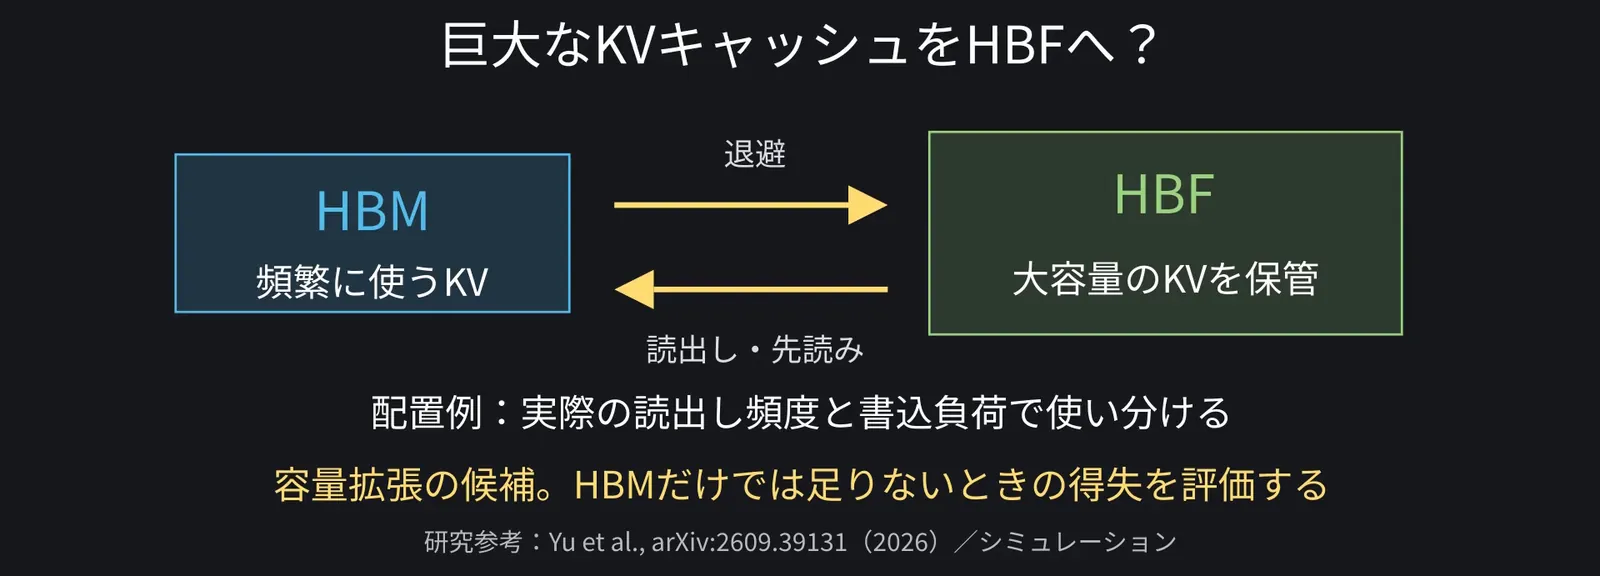
動画の画面(「でも、KVキャッシュがものすごく大きいときには、有効かもしれないのだ!」の場面)
図 39

四国めたん

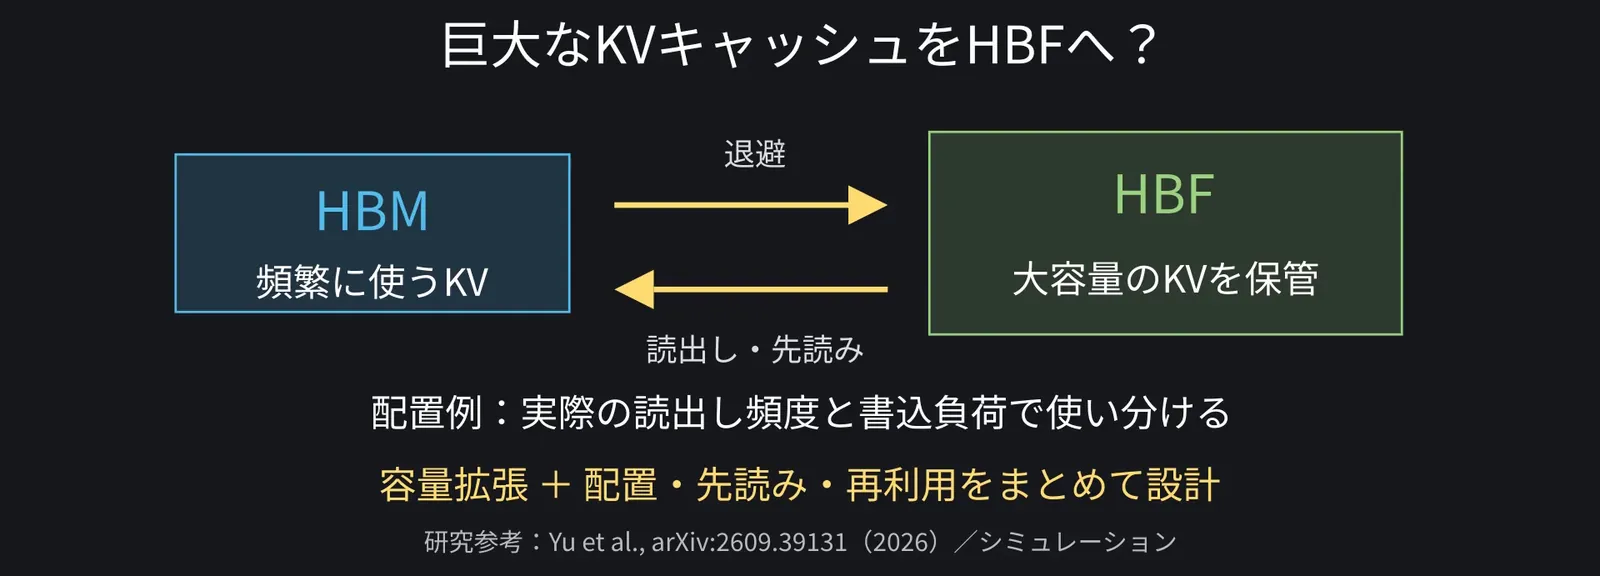
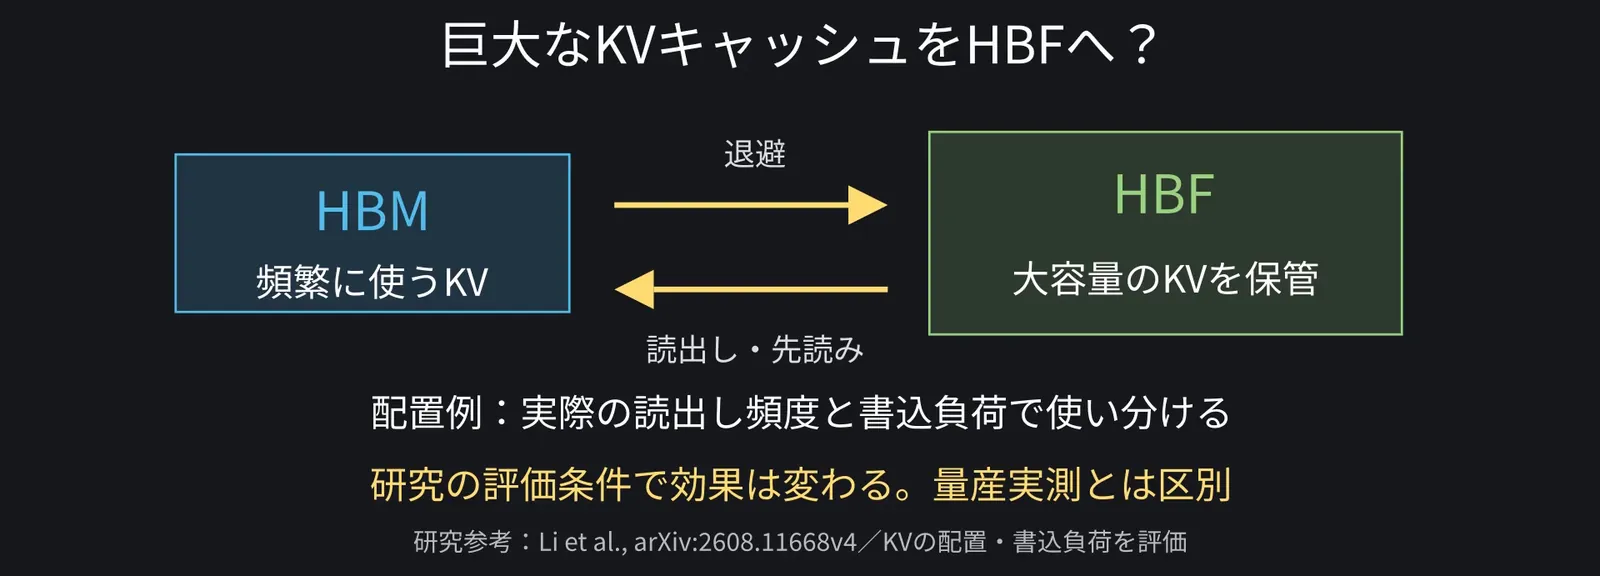
そうね。HBMに収まらないKVを保管し、再利用するための容量拡張は研究されているわ。

四国めたん:ただしKVは生成のたびに追記される。読むだけの重みと違って書き込みが多く、書き換え回数に限りがあるNANDでは負荷や寿命も問題になるの。

四国めたん:頻繁に使う部分をHBMへ、保管する部分をHBFへ。配置や先読みも工夫する必要があるわ。

動画の画面(「頻繁に使う部分をHBMへ、保管する部分をHBFへ。配置や先読みも工夫する必要があるわ。」の場面)
図 40

四国めたん

毎回すべてのKVを読む処理なら、保管先を変えただけでは、読み出し待ちも増えかねないの。

四国めたん:効果は処理内容や再利用しだいね。研究のシミュレーションでも、配置によって結果が変わるわ。

動画の画面(「効果は処理内容や再利用しだいね。研究のシミュレーションでも、配置によって結果が変わるわ。」の場面)
図 41

ずんだもん

大容量を活かしながら、読み書きの待ち時間を隠せるかが勝負なのだ。
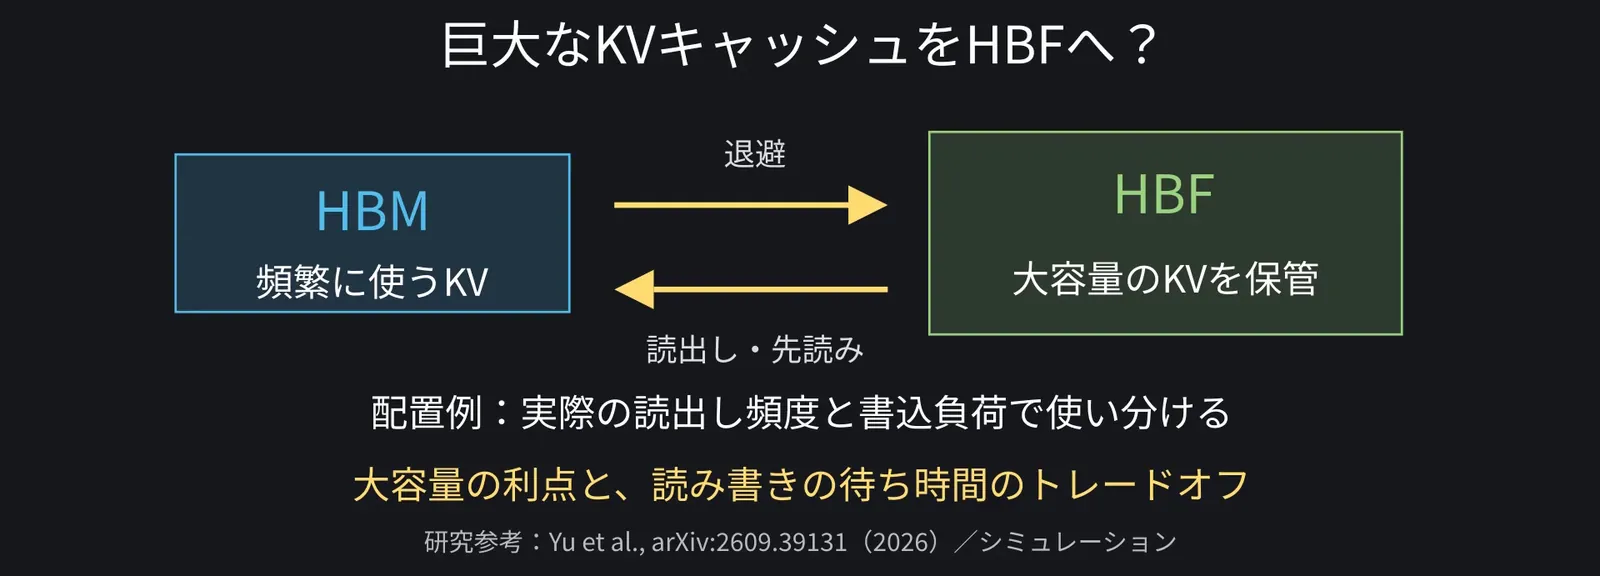
動画の画面(「大容量を活かしながら、読み書きの待ち時間を隠せるかが勝負なのだ。」の場面)
図 42

四国めたん

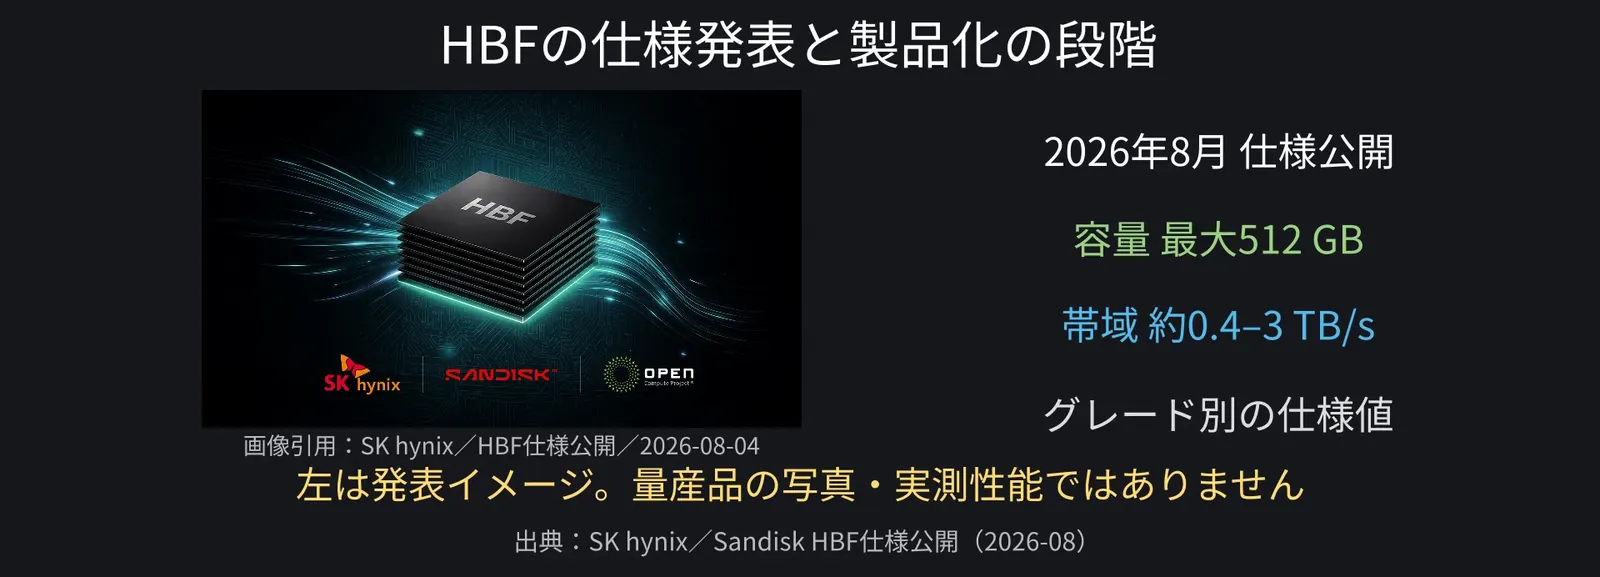
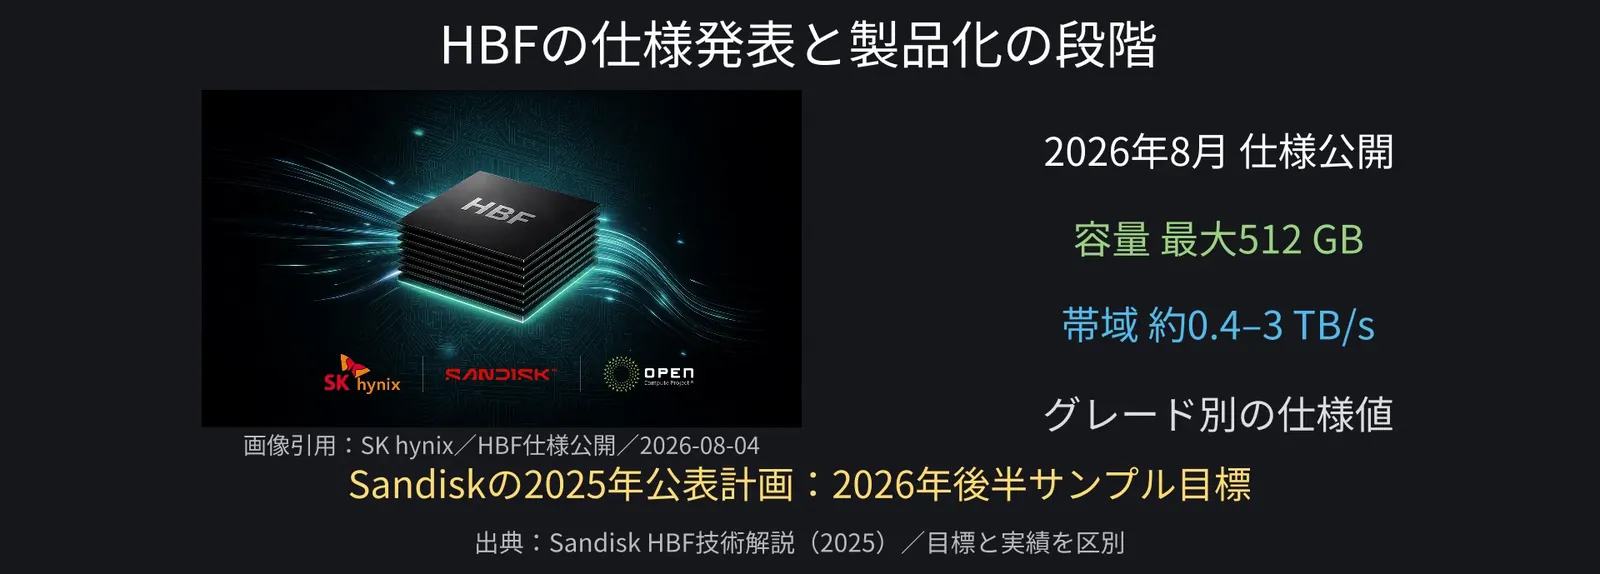
2026年8月、サンディスクとSKハイニックスが、最初のHBF仕様の公開を発表したわ。

動画の画面(「2026年8月、サンディスクとSKハイニックスが、最初のHBF仕様の公開を発表したわ。」の場面)
図 43

四国めたん

最大512GB、帯域はグレード別に毎秒約0.4から3TBという仕様よ。

四国めたん:これは仕様の発表ね。その数字を、量産済みの製品の実測性能とは扱わないわ。

四国めたん:サンディスクは2025年に、翌年後半の初期サンプルを目標と発表。出荷実績とは分けるわ。

動画の画面(「サンディスクは2025年に、翌年後半の初期サンプルを目標と発表。出荷実績とは分けるわ。」の場面)
図 44

10セルを積む3D DRAM研究

ずんだもん質問

3D DRAMという話も聞くのだ。HBMと同じことなのだ?
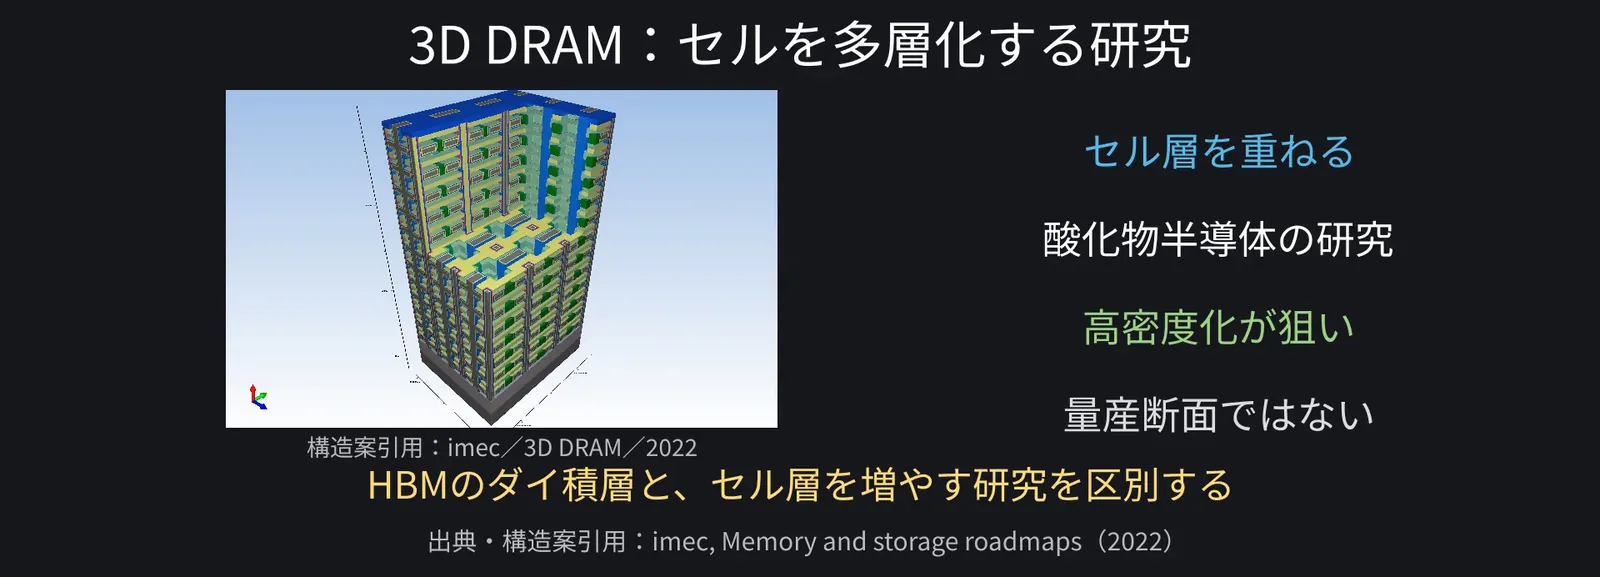
動画の画面(「3D DRAMという話も聞くのだ。HBMと同じことなのだ?」の場面)
図 45

四国めたん

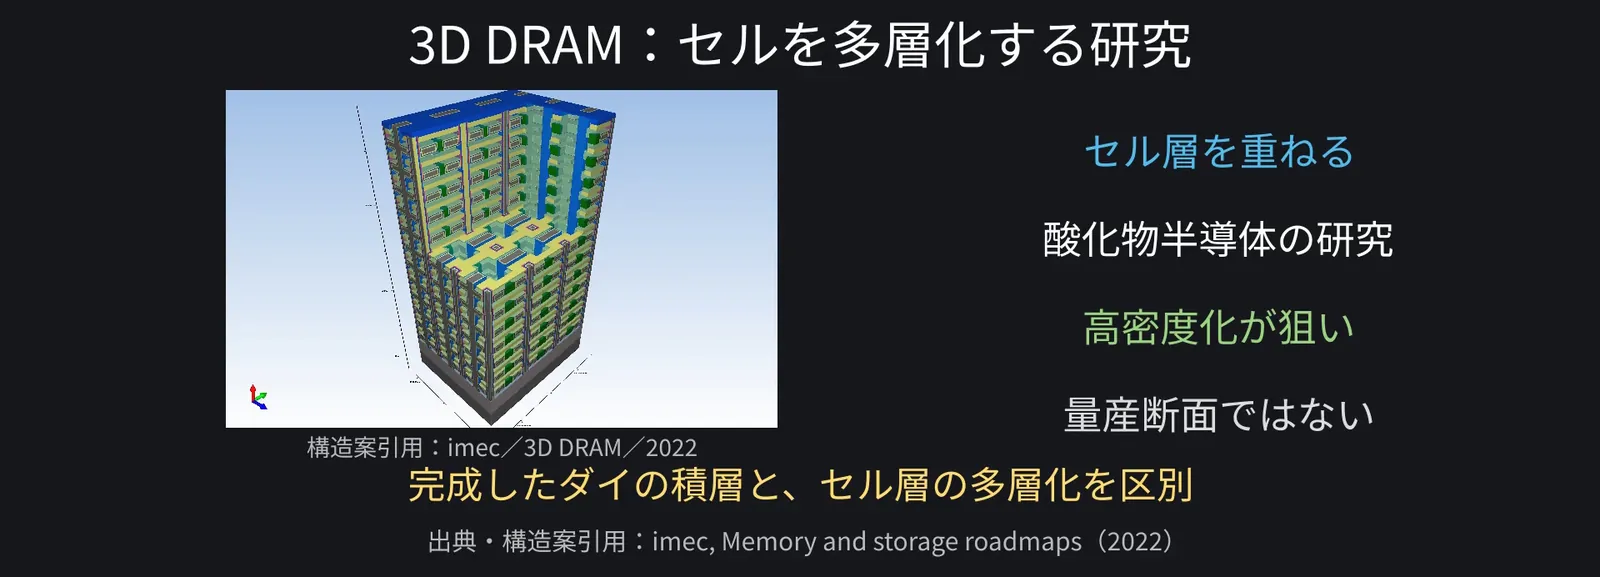
広い意味では呼び方が重なるわ。ここでは、セル自体を多層化する研究を指すことにするね。

四国めたん:完成したDRAMチップを積むHBMと、記憶セルの層を作り重ねる技術を分けて見るの。

動画の画面(「完成したDRAMチップを積むHBMと、記憶セルの層を作り重ねる技術を分けて見るの。」の場面)
図 46

四国めたん

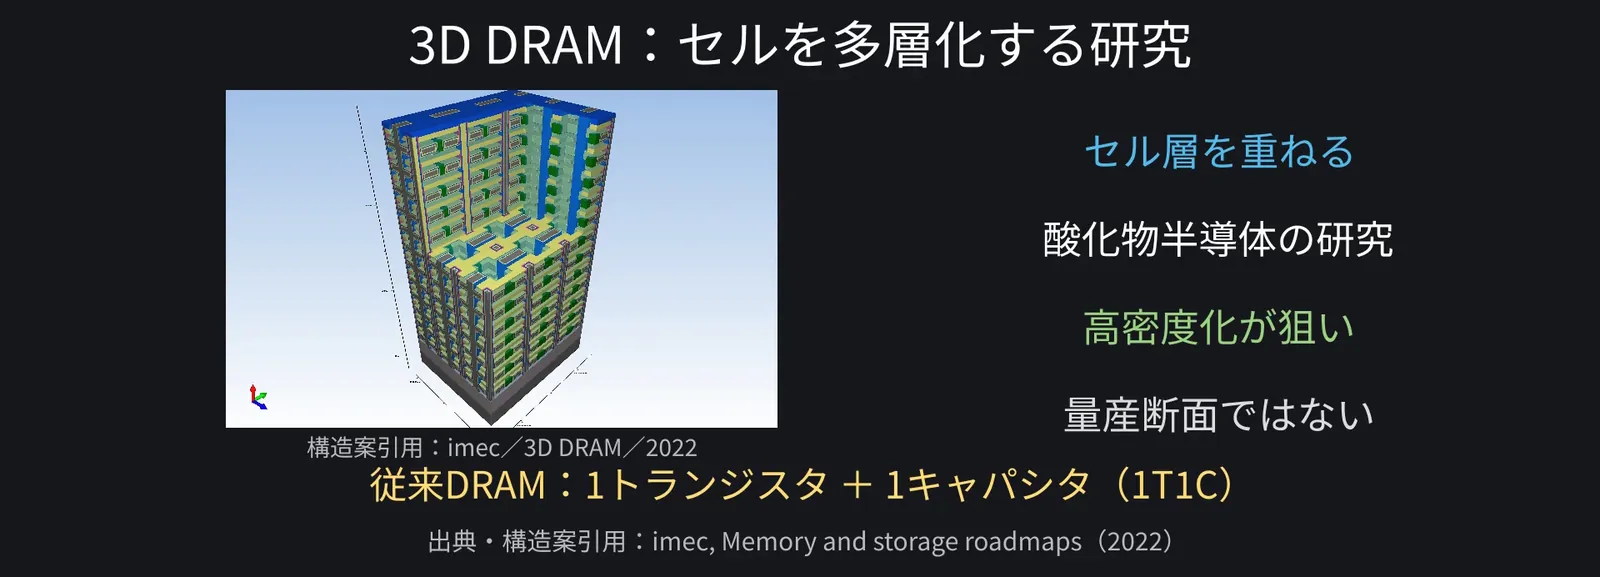
これはimecが示す構造案よ。酸化物半導体を使う、積層向きのセルを研究しているわ。

四国めたん:一般的なDRAMのセルは、トランジスタ1個とキャパシタ1個で情報を保つの。

動画の画面(「一般的なDRAMのセルは、トランジスタ1個とキャパシタ1個で情報を保つの。」の場面)
図 47

四国めたん

この研究では、独立したキャパシタを使わない、2トランジスタ型も検討しているわ。

四国めたん:高密度化が狙いだけれど、保持時間や素子の安定性、積層工程を確かめる必要があるの。

ずんだもん

たくさん保存できても、外へ運ぶ道が細ければ、メモリウォールは残るのだ。
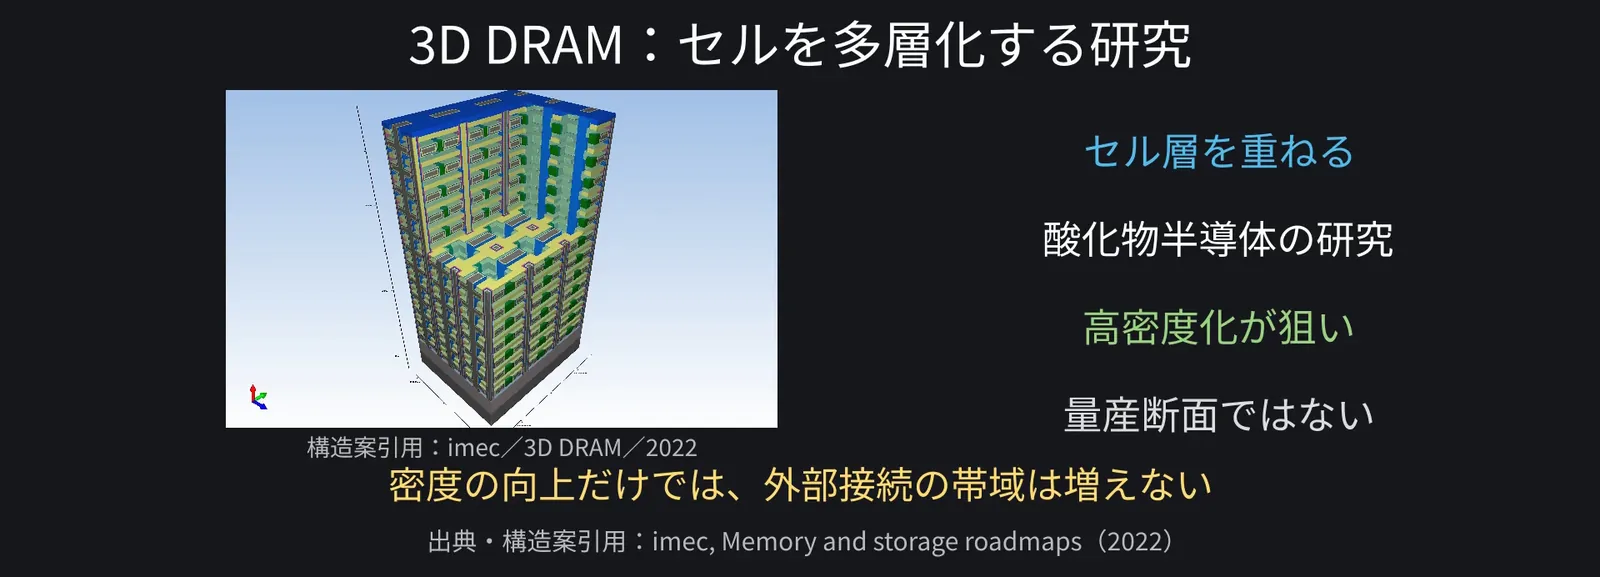
動画の画面(「たくさん保存できても、外へ運ぶ道が細ければ、メモリウォールは残るのだ。」の場面)
図 48

11データ移動を減らす方法

四国めたん

そこで、もっと運べるようにする方法と、そもそも運ぶ量を減らす方法があるわ。

動画の画面(「そこで、もっと運べるようにする方法と、そもそも運ぶ量を減らす方法があるわ。」の場面)
図 49

四国めたん

重みを少ないビットで表す量子化や、近くのメモリで再利用する方法ね。

四国めたん:メモリの近くや中で演算する考え方もあるわ。ただし、動かすデータは残るの。

動画の画面(「メモリの近くや中で演算する考え方もあるわ。ただし、動かすデータは残るの。」の場面)
図 50

12Taalasのモデル特化チップ

ずんだもん

Taalasは、モデルをチップにしてしまうと聞いたのだ!
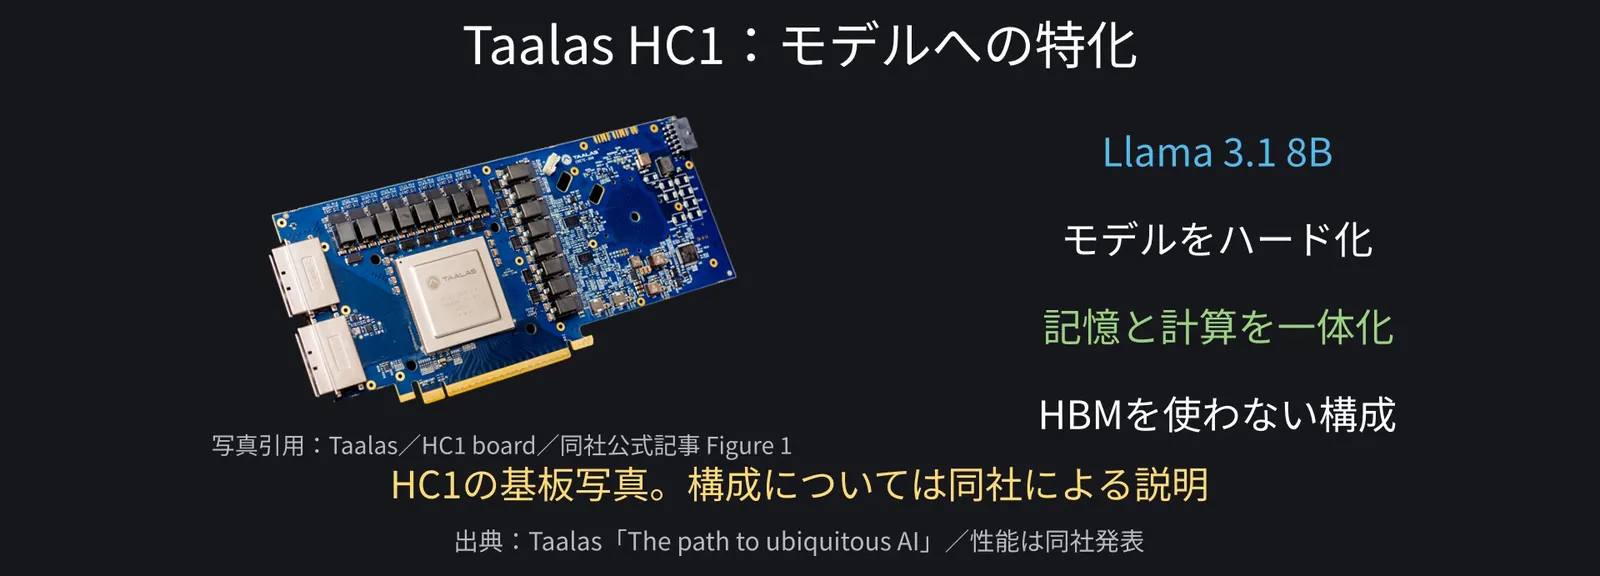
動画の画面(「Taalasは、モデルをチップにしてしまうと聞いたのだ!」の場面)
図 51

四国めたん

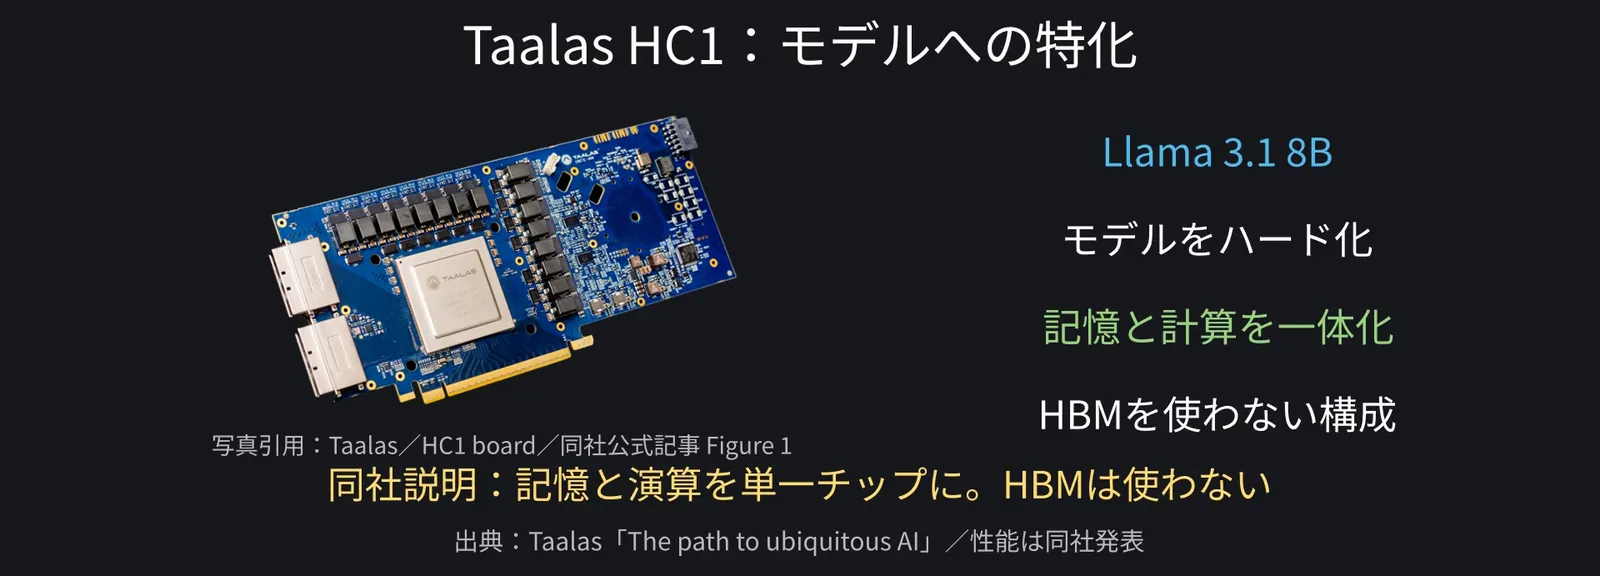
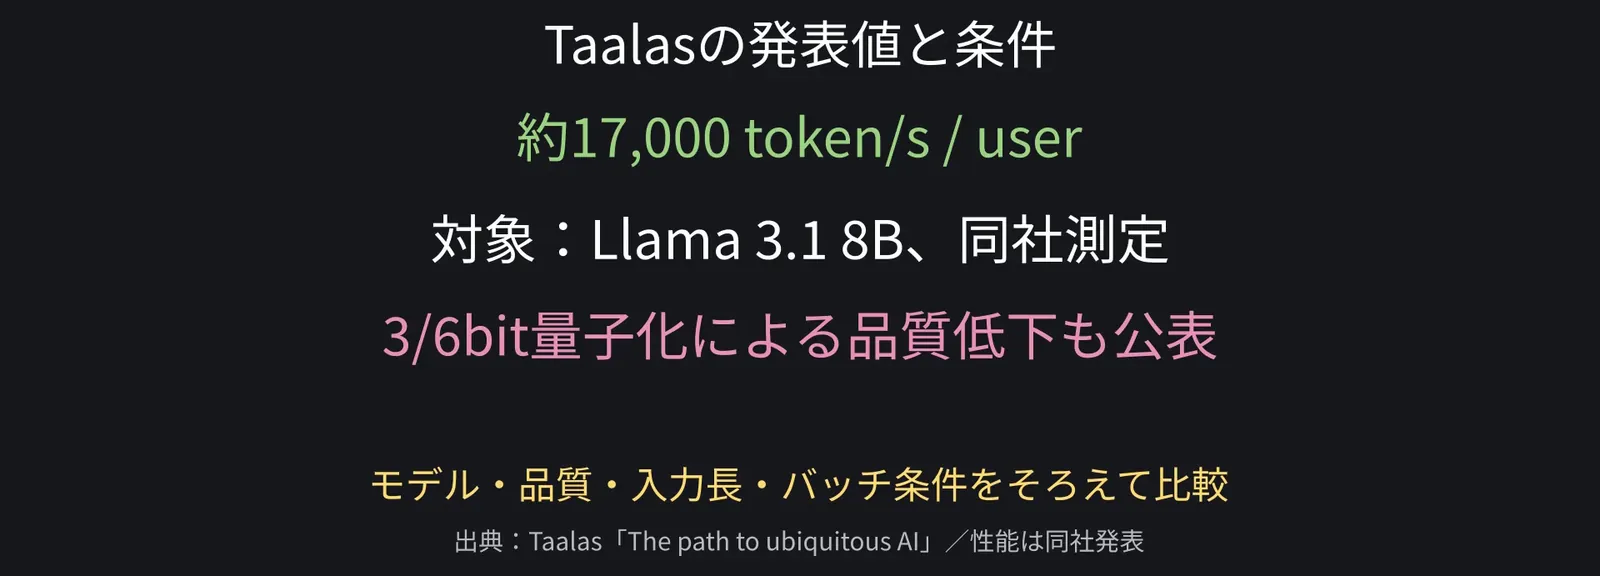
同社のHC1は、Llama 3.1 8B、つまり重みが約80億個のモデルをハードウェアに固定した実例として発表されたわ。

四国めたん:記憶と計算を1チップにまとめ、HBMを使わない構成と説明しているの。

動画の画面(「記憶と計算を1チップにまとめ、HBMを使わない構成と説明しているの。」の場面)
図 52

四国めたん

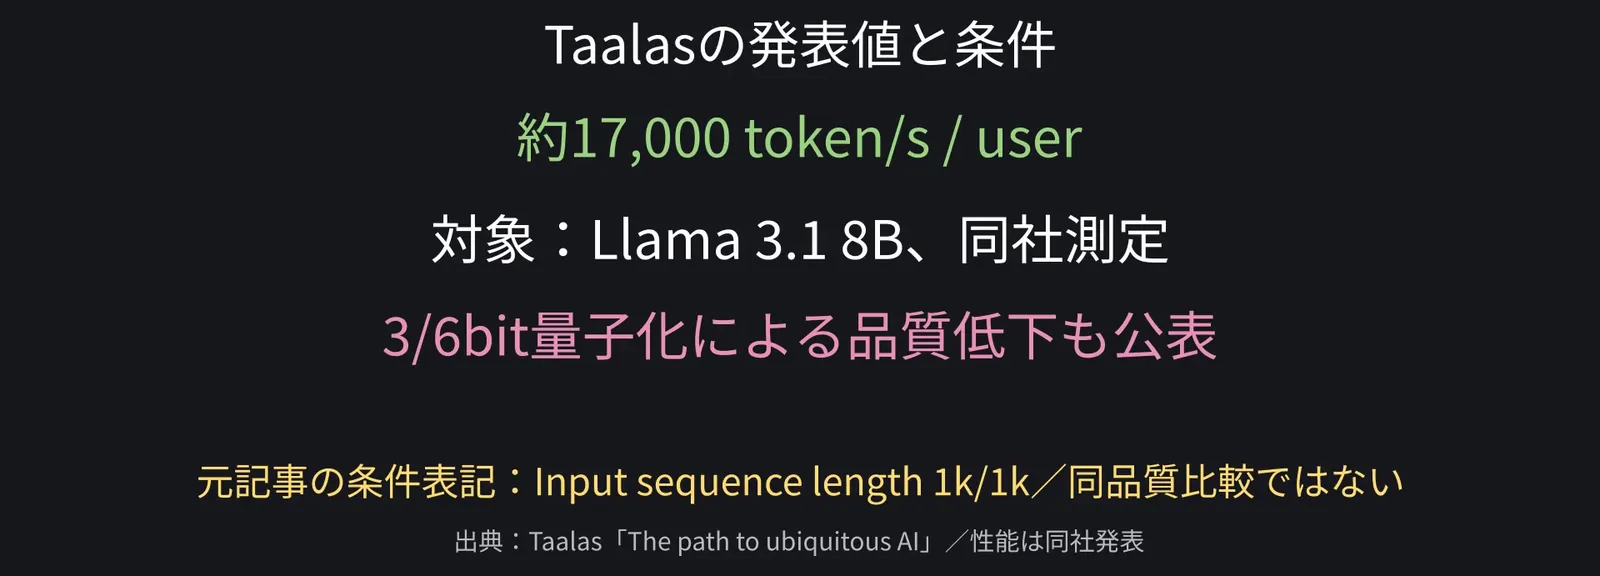
1人あたり毎秒約1万7千トークン。ただし、これは同社が公表した測定結果よ。

動画の画面(「1人あたり毎秒約1万7千トークン。ただし、これは同社が公表した測定結果よ。」の場面)
図 53

四国めたん

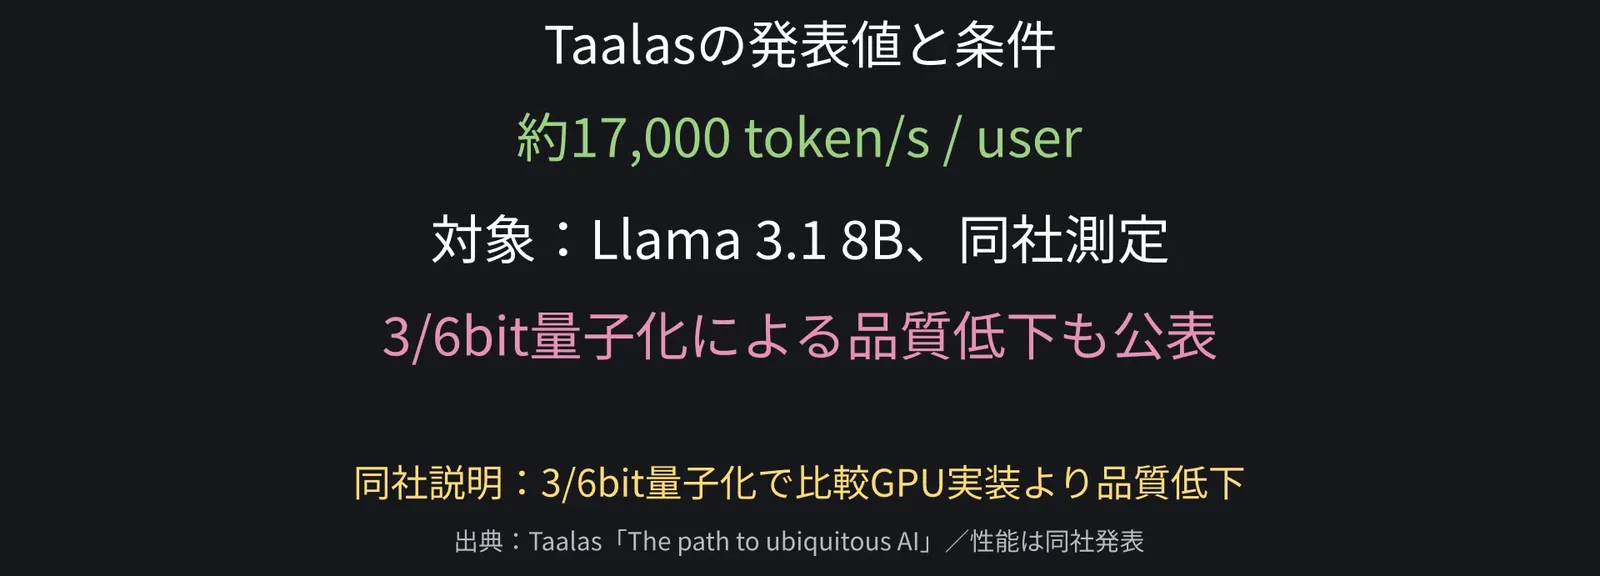
3ビットと6ビットの量子化を使い、比較したGPU実装より品質が下がる点も明記しているわ。

動画の画面(「3ビットと6ビットの量子化を使い、比較したGPU実装より品質が下がる点も明記しているわ。」の場面)
図 54

ずんだもん

速さだけ並べても、同じ品質や同じ条件とは限らないのだ。
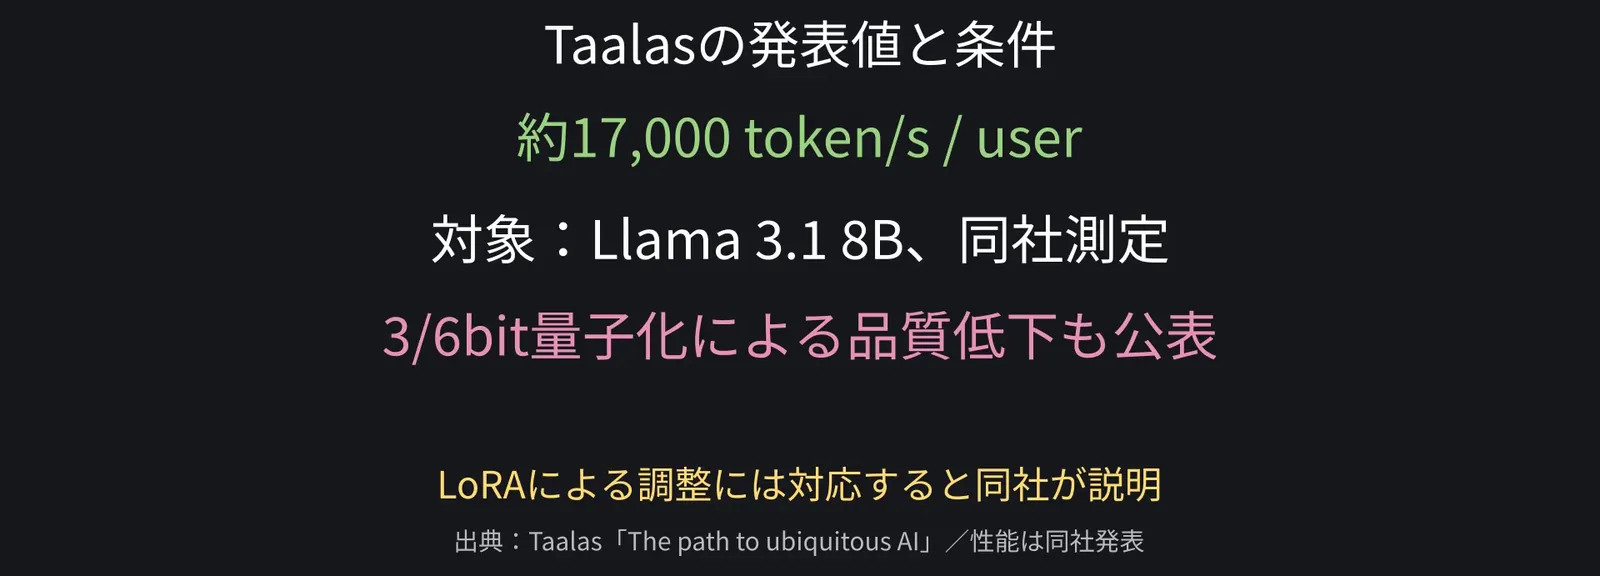
動画の画面(「速さだけ並べても、同じ品質や同じ条件とは限らないのだ。」の場面)
図 55

四国めたん

モデルへの特化が強みね。一方、別のモデルへの変更は、汎用GPUほど自由ではないわ。

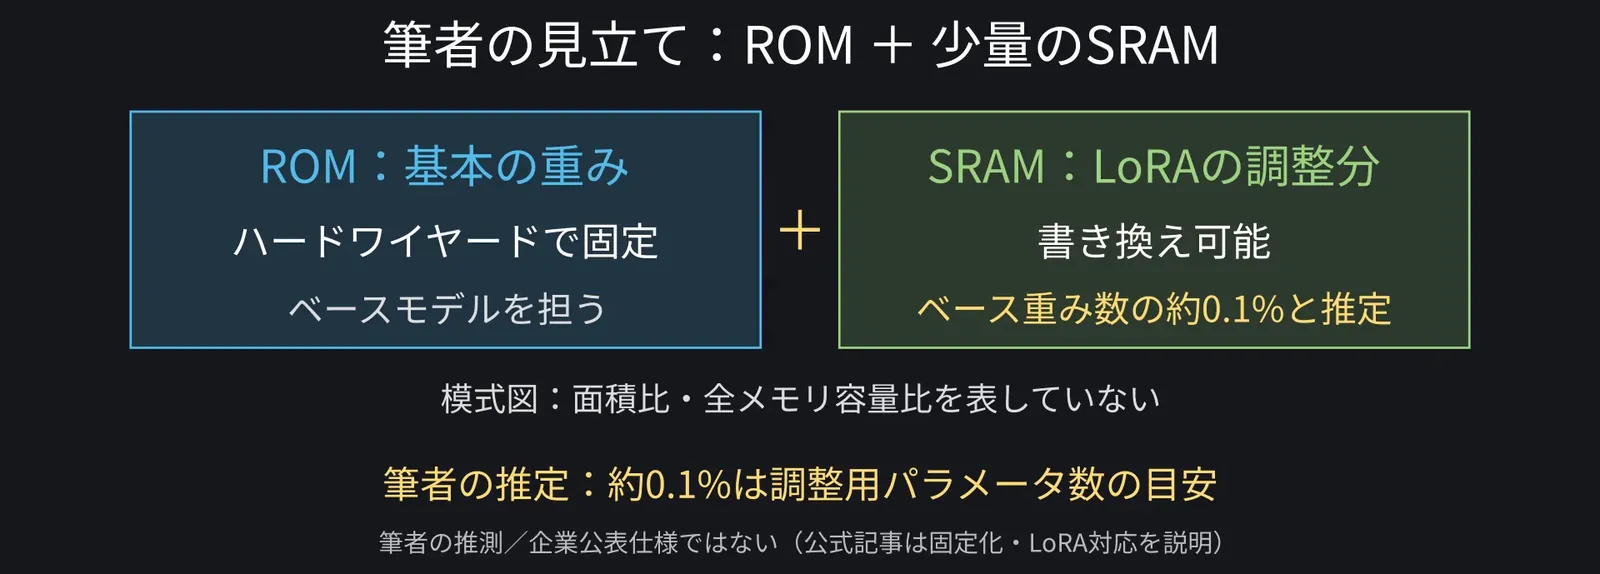
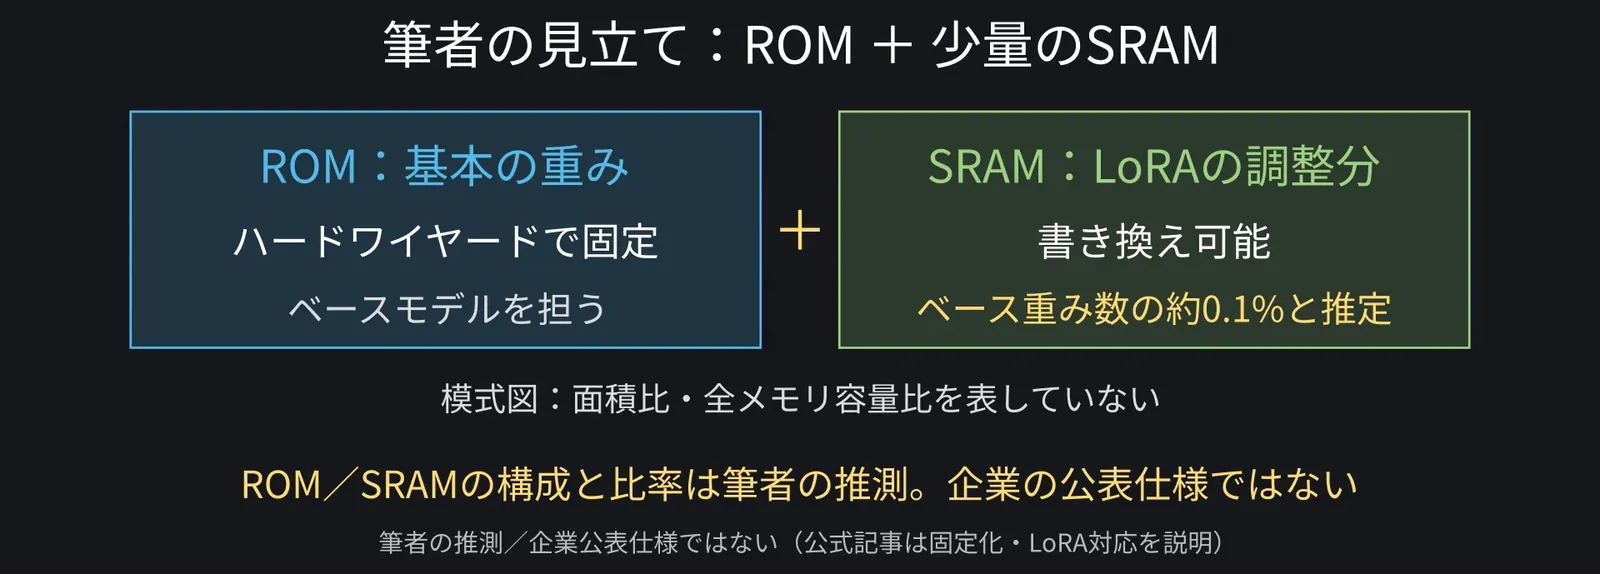
四国めたん:ただし同社はLoRAによる調整に対応すると説明している。全部が変更不能ではないの。

動画の画面(「ただし同社はLoRAによる調整に対応すると説明している。全部が変更不能ではないの。」の場面)
図 56

四国めたん

筆者は、基本の重みをROMに固定した構成と考えているわ。

四国めたん:さらに、重み全体の約0.1%ほどの調整用パラメータだけは、別に持っていると見ているの。

動画の画面(「さらに、重み全体の約0.1%ほどの調整用パラメータだけは、別に持っていると見ているの。」の場面)
図 57

四国めたん

その部分を書き換え可能なSRAMに置き、LoRAで変えるという見立てよ。

四国めたん:この比率や内部構成は筆者の推測で、同社の公式な仕様ではないの。

動画の画面(「この比率や内部構成は筆者の推測で、同社の公式な仕様ではないの。」の場面)
図 58

ずんだもん

これで、どんなAIにもメモリが不要になる、という話ではないのだ。
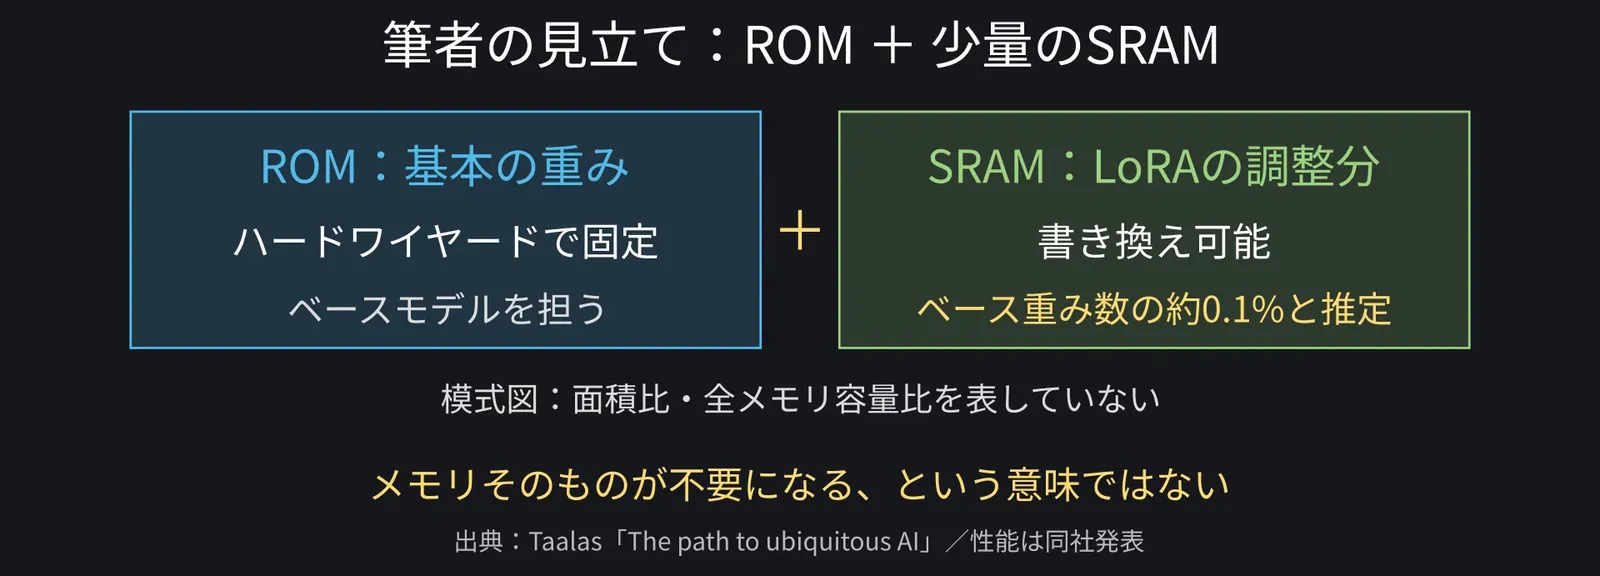
動画の画面(「これで、どんなAIにもメモリが不要になる、という話ではないのだ。」の場面)
図 59

13まとめ:計算とデータ供給

四国めたん

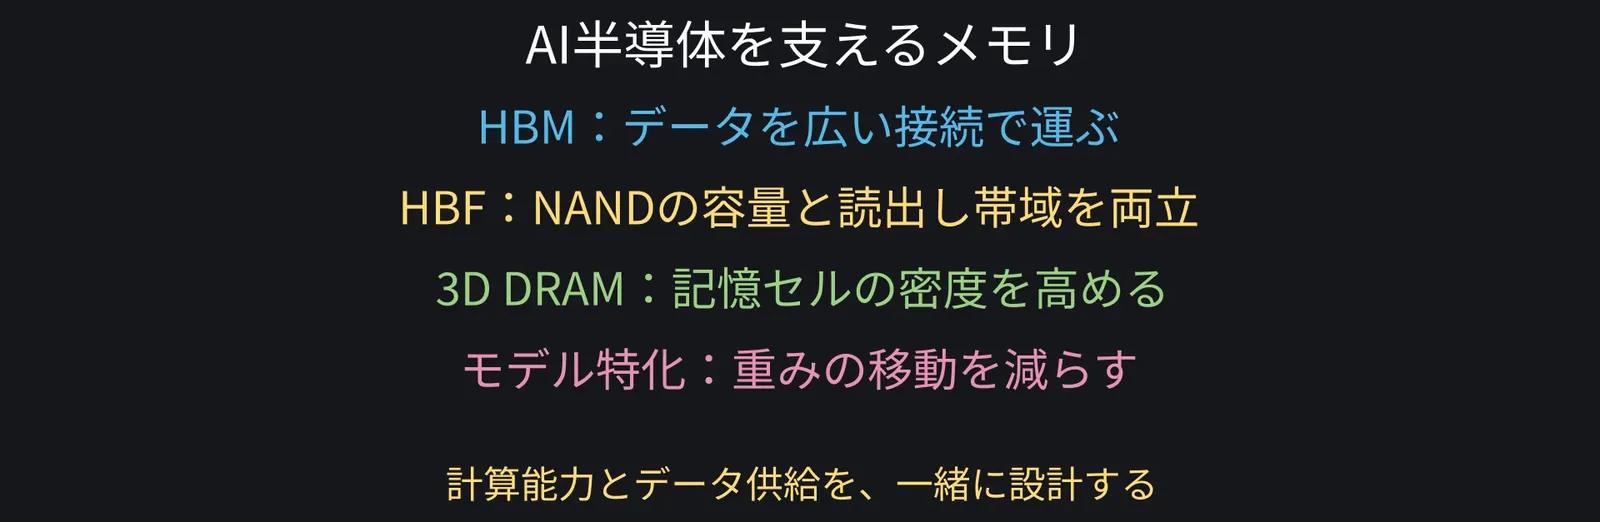
計算の速さを活かすには、必要なデータを、必要な速さで届けることが大切よ。

動画の画面(「計算の速さを活かすには、必要なデータを、必要な速さで届けることが大切よ。」の場面)
図 60

四国めたん

HBMは広い接続で運ぶ。3D DRAMは密度を高める。特化した設計は移動を減らす。

四国めたん:HBFは、NANDの大容量を広い読み出し帯域につなぐ。用途ごとに組み合わせるのね。

動画の画面(「HBFは、NANDの大容量を広い読み出し帯域につなぐ。用途ごとに組み合わせるのね。」の場面)
図 61

ずんだもん

株の名前だけ見ていたけど、メモリが売れる技術の理由が分かったのだ!
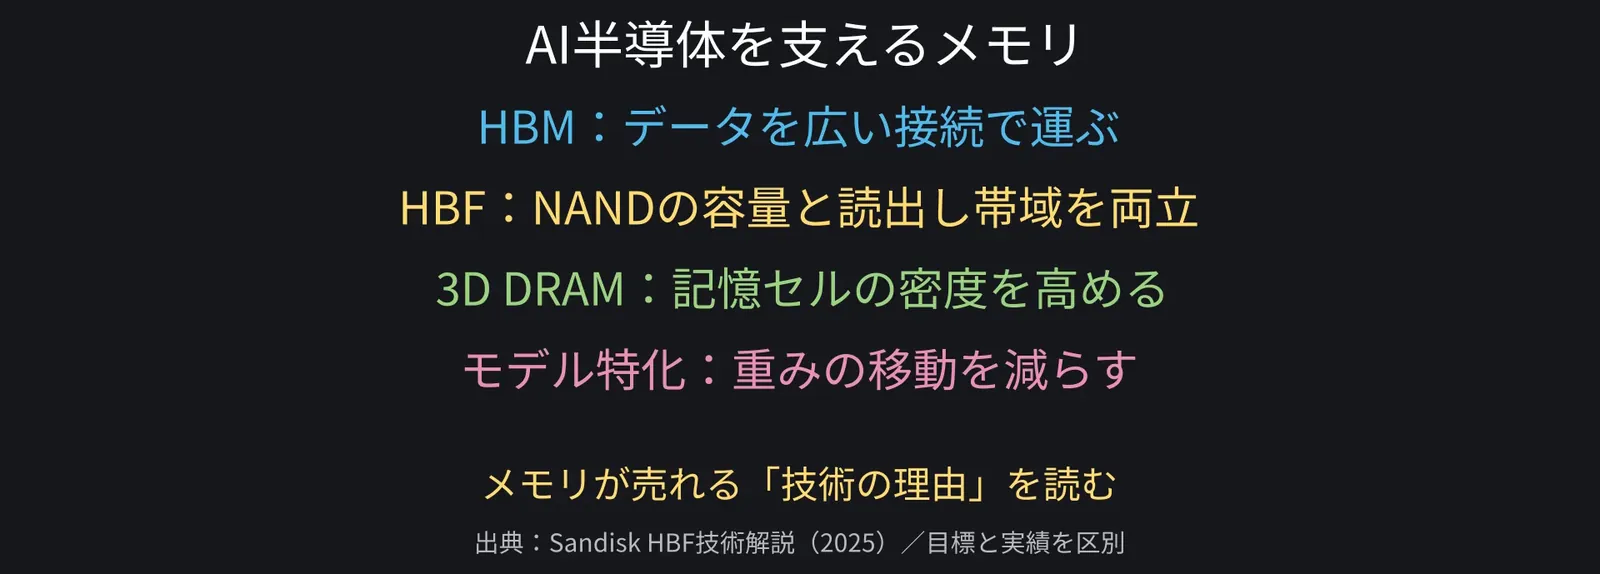
動画の画面(「株の名前だけ見ていたけど、メモリが売れる技術の理由が分かったのだ!」の場面)
図 62

四国めたん

業績は期間と内訳、技術は容量と帯域を分けて読むと、ニュースがぐっと分かるわ。

ずんだもん

最後まで読んでくれてありがとうなのだ!